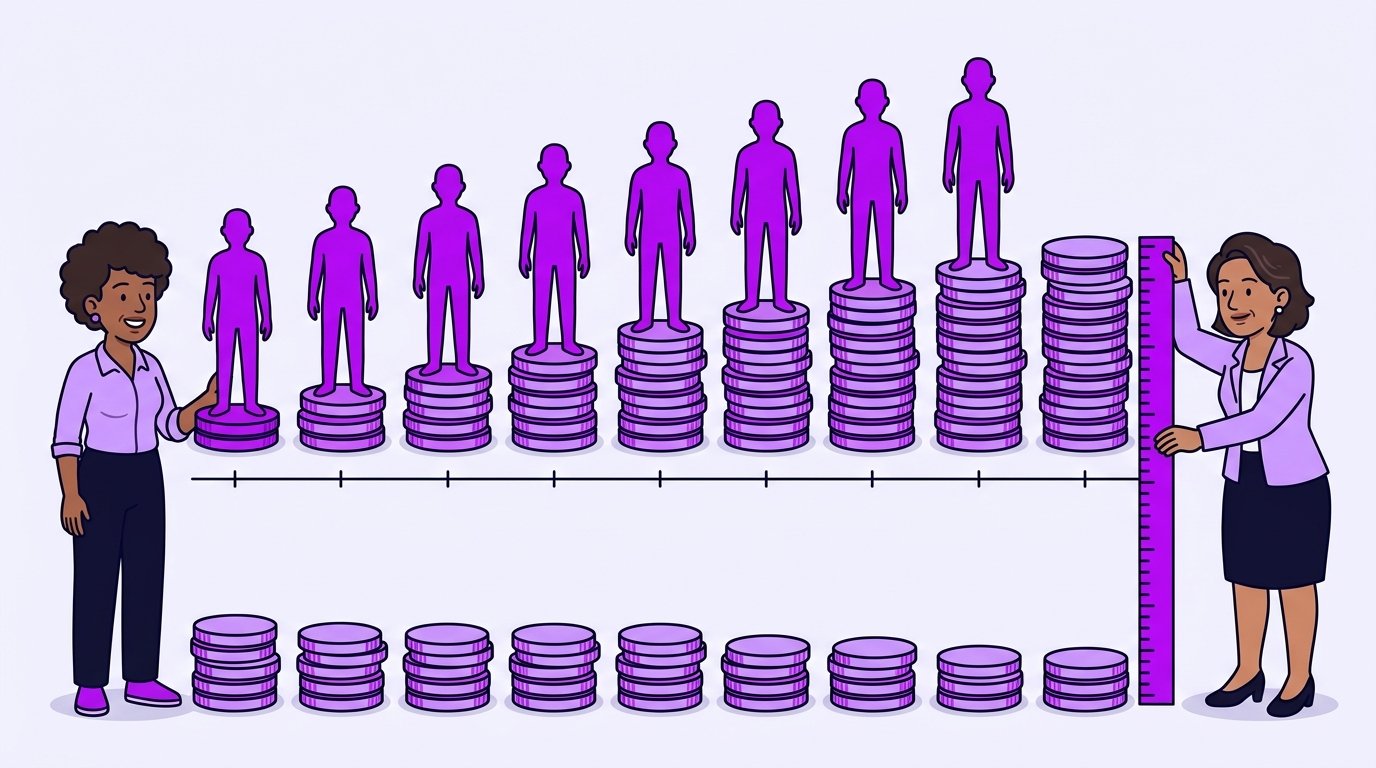
Para uma equipe pequena, 24 meses de Claude Code Pro somam cerca de R$ 2.460. O mesmo período assinando um CRM (sistema que organiza clientes e vendas) pronto para 3 pessoas — RD Station ou Pipedrive, nos planos de entrada — fica entre R$ 5.200 e R$ 9.400. O SaaS (software alugado por mensalidade) cobra por usuário; a IA não.
A assinatura cresce a cada pessoa que entra na equipe. Construir tem custo quase fixo ao longo dos dois anos.
Isso não quer dizer que construir seja sempre mais barato. Quer dizer que a conta muda conforme o número de pessoas que usam o sistema. É isso que a maioria dos comparativos esquece de mostrar.
Quanto custa manter a ferramenta de IA rodando por 2 anos?
O Claude Code entra no plano Pro da Anthropic, hoje em US$ 20/mês (ou US$ 17/mês no anual). Convertendo pela cotação de 22/09/2026 (US$ 1 = R$ 5,13), são R$ 102,60/mês — R$ 2.462,40 em 24 meses.
Existe o plano Max, a partir de US$ 100/mês (R$ 513, ou R$ 12.312 em 2 anos). Ele é para quem usa a IA o dia inteiro em vários projetos. Para construir e manter um sistema, o Pro é o que a maioria usa.
Quanto custa a SaaS pronta pelo mesmo período?
Pegando dois CRMs populares no Brasil como referência, para uma equipe de 3 pessoas em 24 meses:
Ferramenta
Plano de entrada
Por usuário/mês
3 usuários, 24 meses
RD Station CRM
Basic
R$ 73
R$ 5.256
Pipedrive
Lite
~R$ 72 (US$ 14)
R$ 5.171
RD Station CRM
Pro
R$ 131
R$ 9.432
Pipedrive
Growth
~R$ 123 (US$ 24)
R$ 8.865
Mesmo no plano mais barato de cada uma, a SaaS pronta custa mais de 2x o valor de manter o Claude Code no mesmo período. O motivo não é o preço da ferramenta em si. É que ela cobra por assento (cada pessoa com login paga à parte). Sistema construído não tem essa conta: o 4º e o 5º usuário não somam nada na mensalidade.
Por que a cobrança por usuário é uma armadilha?
A armadilha é que o preço cresce sem ninguém decidir comprar nada. Basta contratar alguém.
Faça a conta com os próprios números da tabela. Com 5 pessoas no RD Station CRM Basic, são R$ 73 × 5 × 24 meses: R$ 8.760. No Pipedrive Lite, cerca de R$ 8.620. A mensalidade da IA continua em R$ 2.462,40 no mesmo período.
O caminho inverso também engana. Com 1 usuário só, o RD Station Basic sai por R$ 1.752 em 24 meses. Aí o SaaS é mais barato que a IA. A virada acontece a partir do 2º usuário.
Isso não esconde o custo de construir de verdade?
Esconde uma parte, e é justo dizer isso. A mensalidade da IA não inclui as horas que alguém gasta desenhando e testando o sistema. Isso é tempo real, não é de graça só porque não tem boleto.
A diferença é que esse custo acontece uma vez. A mensalidade da SaaS se repete todo mês, para sempre. E sobe de preço quando o plano é reajustado ou quando a equipe cresce.
Como fazer essa conta para o seu caso?
1. Conte quem usa. Quantas pessoas precisam de login no sistema hoje? E daqui a um ano? 2. Multiplique. Preço por usuário × número de pessoas × 24 meses. 3. Compare. Ponha o resultado ao lado dos R$ 2.462,40 do plano Pro. 4. Some as horas. Estime quantas horas alguém vai gastar para construir e testar. Esse tempo entra do lado de construir.
Se a diferença do passo 3 não paga as horas do passo 4, assine o pronto.
Quem precisa estar no negócio para construir valer a pena?
Alguém com tempo para desenhar e testar o sistema. E alguém para cuidar da manutenção depois. Pode ser a mesma pessoa. Sem esse alguém, a economia da tabela não sai do papel.
Quando construir se aplica bem — e quando o SaaS ainda vale mais?
Construir se aplica bem quando:
a equipe tem 2 ou mais pessoas usando o sistema;
a equipe tende a crescer, e cada novo login pesaria na mensalidade;
existe alguém com tempo para construir e manter.
O SaaS pronto ainda vale mais quando:
o sistema precisa estar rodando hoje, sem ninguém disponível para desenhar nada;
a equipe muda de ferramenta o tempo todo e não tem quem cuide da manutenção;
falta um recurso muito específico do CRM pronto — integração nativa, app mobile, suporte
24h — que sairia mais caro reconstruir do que assinar;
Este site foi construído por quem já passou pelos dois lados: manteve um CRM próprio rodando em produção, feito com o mesmo método deste artigo. A diferença que aparece na prática não é só o preço. A mensalidade fixa da ferramenta de IA não muda se o negócio cresce de 3 para 30 leads (contatos interessados) por dia. A da SaaS por usuário, muda.
O que a gente faria no seu lugar?
Com uma pessoa só usando o sistema, a gente assinaria o SaaS. A conta é clara: R$ 1.752 no RD Station Basic contra R$ 2.462,40 da IA em 24 meses. Não vale construir para pagar mais.
Com 3 pessoas ou mais, a gente construiria — desde que tivesse alguém com tempo para isso. A diferença mínima da tabela passa de R$ 2.700 em dois anos. Isso paga muitas horas de teste.
O que a gente não faria: assinar o plano Max para construir um único sistema. Os R$ 12.312 em 2 anos passam de qualquer CRM da tabela. Também não construiríamos se o sistema precisasse estar no ar amanhã.
Em resumo: para uma equipe pequena, 24 meses de Claude Code custam menos da metade do CRM pronto mais barato do mercado — mas o cálculo já embute o tempo de construir, que a SaaS não cobra. Vale mais a pena quando alguém no negócio tem esse tempo; não vale quando o sistema precisa nascer pronto hoje.
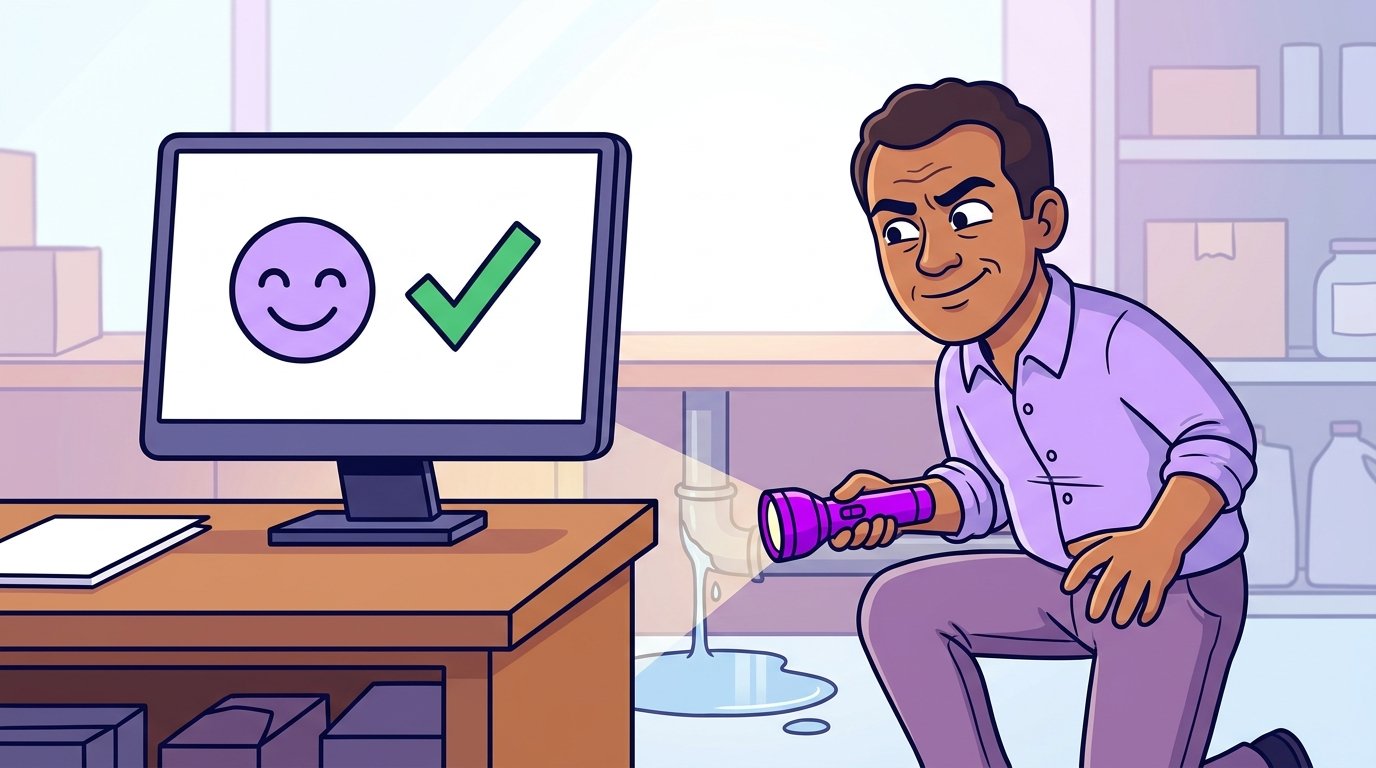
Quem conserta é quem construiu, mas só se existir prova de que quebrou de verdade — não a tela dizendo que deu certo. Numa campanha de anúncios que administro, a tela mostrava “orçamento salvo”, mas ao recarregar a página o valor voltava a R$0,00. O conserto foi recarregar, comparar com o que ficou gravado, e refazer até bater.
A tela dizia que estava tudo certo. A prova de que funcionou vem de conferir o resultado de verdade.
Isso muda a resposta para “quem conserta”. Não basta pedir para a IA arrumar de novo. Primeiro é preciso provar onde a informação parou de bater: na tela, no servidor (o computador onde o sistema guarda os dados de verdade) ou nos dois.
Por que uma tela pode mostrar “sucesso” e não ter salvo nada?
Porque a confirmação na tela e o dado gravado no servidor são duas coisas separadas. Uma pode falhar sem a outra perceber. A tela só avisa que o pedido saiu. Ela não garante que o pedido chegou e foi aceito.
No caso da campanha de anúncios, um aviso de verificação de identidade da conta tinha aparecido pouco antes. A suspeita é que aquilo travou a escrita em silêncio numa etapa específica do processo. As outras etapas continuavam respondendo normal.
O sintoma: o campo de orçamento diário voltava a zero a cada recarregamento. Isso mesmo depois de digitar o valor várias vezes e a tela confirmar “salvo”. Palavras-chave e anúncio também não existiam de verdade no servidor, apesar de o assistente mostrar tudo pronto.
Onde falha a automação que responde “ok”?
Nos pontos em que o sistema responde “ok” para uma coisa e faz outra. O orçamento zerado não foi um caso isolado. No mesmo trabalho com anúncios e com um CRM (o sistema que guarda a lista de contatos e clientes), apareceram outras falhas da mesma família:
Onde falhou
O que a tela dizia
O que era de verdade
Limite de preço por clique
Campanha pronta
Campo vazio: a campanha podia pagar quanto quisesse por clique
Extras do anúncio importados por planilha
Importação concluída
Os extras nunca subiram
Título de anúncio importado
Texto aceito
Uma palavra perdeu letras por erro de acentuação e virou outra palavra válida
Formulário do CRM
“Enviado com sucesso”
O contato com telefone repetido foi juntado ao antigo, sem criar um novo
Por que esses erros enganam até quem confere?
O limite de clique vazio custou R$19,45 num único dia: 3 cliques, a R$6,48 cada, em média. Foi o erro mais barato de descobrir e o mais caro de ignorar.
O caso do título é o mais traiçoeiro. Não sobrou nenhum símbolo estranho para dar alarme. Só comparando campo a campo com o texto original dava para ver.
O do formulário engana até quem testa. Quem reenvia com o mesmo telefone de teste acha que o contato “não chegou”. Ele chegou, só foi juntado ao que já existia.
Como descobrir que algo quebrou antes que vire prejuízo?
Recarregando a página depois de qualquer ação de salvar, sempre. A mensagem de sucesso sozinha nunca vale como prova.
Foi assim que, numa checagem de rotina, apareceram duas campanhas ativas gastando com a lista de palavras bloqueadas completamente vazia. O plano de bloqueio existia no registro interno. Mas nunca tinha sido aplicado de fato na campanha real. As duas foram pausadas assim que o problema apareceu.
Na prática, a conferência tem quatro passos:
1. Salvar e recarregar a página, sem confiar no aviso de “salvo”. 2. Comparar o valor na tela com o valor que você pediu, número por número. 3. Testar com um dado novo, nunca com um que o sistema já conhece. 4. Anotar a diferença antes de pedir o conserto, para a IA atacar a causa e não o sintoma.
Sinal de alerta
O que ele revelou
Campo de orçamento voltava a R$0,00 sozinho
Escrita bloqueada silenciosamente numa etapa específica
Lista de bloqueio vazia numa campanha ativa
Configuração planejada nunca aplicada de verdade
Aviso de “verificação de identidade” pendente
Provável causa raiz das duas falhas acima
Quem é responsável quando a IA constrói e algo quebra depois?
Quem construiu investiga a causa. No meu caso, sempre com o Claude Code lendo o erro e propondo o conserto. Mas quem aprova religar o que estava quebrado é sempre uma pessoa, nunca a própria automação sozinha.
No caso das campanhas pausadas, a reativação ficou esperando aprovação humana mesmo depois da correção aplicada. O motivo: aquele erro específico ainda não tinha explicação 100% confirmada.
Essa divisão virou regra escrita. Ajuste técnico de configuração, como preencher uma lista de palavras bloqueadas, pode ser feito e mostrado depois. Já qualquer valor em dinheiro — orçamento, lance, custo por venda — só muda com o “ok” da pessoa, vendo o número atual e o novo lado a lado.
Pausar campanha também pede esse “ok”. Ligar anúncio, nunca: esse clique é sempre humano. E com campanha no ar, um “pode seguir” dado antes não vale para um valor novo.
Quando essa regra se aplica bem — e quando não?
Ela se aplica bem nos seguintes casos:
Automação que mexe com dinheiro, como anúncio, cobrança ou orçamento.
Sistema que grava dado de cliente, como CRM ou formulário de cadastro.
Importação em lote por planilha, em que um erro se repete em muitas linhas de uma vez.
Qualquer tela em que a plataforma mostrou um aviso pouco antes, como um pedido de verificação de conta.
Ela vale menos esforço quando o resultado aparece na sua frente na hora e não custa nada errar. Um rascunho, um teste que ninguém vai usar para decidir, um botão que mudou de cor. Nesses casos, recarregar e comparar custa mais tempo do que o erro custaria.
O que muda depois desse tipo de erro?
Vira regra permanente: toda ação de “salvar” passa a ser conferida recarregando a tela, nunca pela mensagem de sucesso isolada.
É o mesmo princípio por trás de tratar dado sensível com cuidado redobrado, descrito em é seguro usar IA com dado de cliente no meu negócio. Confiar sem checar é o erro que se repete em qualquer sistema automatizado, não só em anúncio.
O que a gente faria no seu lugar?
Nós trataríamos toda mensagem de “salvo com sucesso” como um palpite, não como prova. O motivo está no próprio caso: o orçamento voltou a R$0,00 várias vezes com a tela dizendo “salvo”. E o limite de clique vazio custou R$19,45 em um dia só.
Faríamos a conferência logo depois de cada ação que mexe com dinheiro ou com dado de cliente. Não no fim do mês, quando o estrago já somou.
O que não faríamos: pedir para a IA “arrumar de novo” sem antes mostrar onde a tela e o dado gravado divergem. Também não deixaríamos a própria automação religar o que estava quebrado. Religar é decisão de uma pessoa.
Em resumo
Quando uma automação construída com IA quebra depois de pronta, quem conserta é quem construiu. Mas o primeiro passo nunca é confiar na mensagem de sucesso da tela.
É comparar o que a tela mostra com o que realmente está gravado, achar onde os dois divergem, e só então religar, com aprovação humana explícita.
Não existe um número único — depende do tamanho da peça, não da ferramenta. Uma correção pontual, destravando uma automação que faltava só uma configuração, saiu do diagnóstico até validada em produção em 1 dia. Já um sistema de conteúdo publicando sozinho levou 20 dias corridos até bater a primeira meta de volume.
Trocar uma peça leva um dia; construir a casa inteira leva semanas. O prazo depende do tamanho do que se constrói.
A diferença entre os dois casos não é a ferramenta usada. É o que cada um exigia. O primeiro precisava só de um diagnóstico certo. O segundo precisava de um processo repetido várias vezes, com revisão humana em cada rodada.
Qual foi o exemplo mais rápido?
Um CRM (o sistema que guarda os contatos que chegam e em que etapa cada um está) estava etiquetando só 2 de 7 leads recebidos. Lead é a pessoa que deixou o contato num formulário.
O diagnóstico veio rápido. O sistema só colocava etiqueta automática em quem comprava. A etiqueta de quem apenas chegava dependia de uma configuração no painel. E seis formulários tinham a “etiqueta de entrada” vazia. Um sétimo apontava para uma etiqueta que já tinha sido apagada.
A correção foi feita e testada em produção. Um lead de teste, com telefone nunca usado antes, entrou com a etiqueta certa. O contador da etiqueta foi de 0 para 1. Depois o lead de teste foi apagado, e o contador voltou a 0.
Do problema identificado até a correção confirmada em produção: 1 dia.
Qual foi o exemplo mais longo?
Um site de conteúdo escrito com IA, publicando sozinho depois de aprovado. O plano nasceu em meados de agosto. O primeiro artigo foi ao ar alguns dias depois.
A meta de volume era de 15 artigos publicados, o número mínimo definido antes de qualquer outro passo. Bater essa meta levou 20 dias corridos a partir do primeiro artigo. Até a data desta publicação, o site chegou a 27 artigos no total.
Etapa
Tempo real
Diagnóstico simples até correção validada (CRM)
1 dia
Plano até primeiro artigo publicado
poucos dias
Primeiro artigo até bater a meta de 15
20 dias corridos
Total até 27 artigos publicados
cerca de 1 mês corrido
Por que a mesma abordagem demora dias num caso e um dia noutro?
Porque o gargalo nunca foi a IA escrever ou corrigir código. Isso acontece em minutos nos dois casos. O gargalo é quantas vezes o resultado precisa passar por revisão humana antes de valer como “pronto”.
A correção do CRM passou por uma checagem e foi liberada. Cada lote de artigos passa por validação automática de estrutura. Depois passa por uma auditoria manual de fatos antes de ser agendado.
E a própria regra do projeto limita a publicação a no máximo 3 artigos por dia, de propósito. A ideia é não parecer um despejo automático de conteúdo. Ou seja: parte do prazo é escolhida, não imposta pela ferramenta.
Quando o prazo estoura, qual é o problema de verdade?
Quase nunca é a velocidade da IA. Nos dois casos, o que segurou o relógio foram três coisas que não aparecem na estimativa inicial.
A primeira é o acesso. No mesmo CRM, um segundo defeito ficou aberto: contatos com o mesmo telefone escrito de jeitos diferentes viram dois cadastros. O conserto está entendido. Mas depende de entrar no servidor (o computador onde o sistema roda de verdade), e esse acesso ainda não estava liberado. Sem acesso, nem 1 hora de trabalho vira entrega.
A segunda é a espera por dado real. Depois da correção, as etiquetas novas ficaram zeradas por um tempo. Não era defeito: nenhum contato novo tinha chegado ainda. Só dá para confirmar com o movimento de verdade.
A terceira é a revisão. No site, cada rodada de artigos para numa auditoria de fatos. Quanto mais rodadas, mais dias.
O que conta como “pronto” — código funcionando ou rodando sozinho sem supervisão?
São coisas diferentes, e é aí que a maioria das estimativas erra. É o mesmo efeito descrito na Lei de Hofstadter: tudo demora mais do que se espera, mesmo levando em conta que tudo demora mais do que se espera.
Código funcionando uma vez, numa tela de teste, pode sair em horas. Um sistema rodando sozinho, de forma confiável, sem alguém checando cada execução, é outra conta. Isso só se prova depois de ver rodar várias vezes seguidas sem quebrar.
É por isso que o exemplo do conteúdo, mesmo com a escrita automatizada, levou semanas. Não pela escrita, mas pelo número de ciclos de revisão antes de confiar no piloto automático.
Como estimar o prazo do seu projeto antes de começar?
Dá para fazer a conta com quatro perguntas, usando os dois casos acima como régua:
1. É um conserto ou um sistema novo? Conserto com causa clara cabe em 1 dia. Sistema que precisa rodar sozinho se mede em semanas. 2. Quantas rodadas de revisão humana ele exige? Cada rodada soma tempo, mesmo que a IA termine em minutos. 3. Você já tem acesso a tudo? Senha, painel, servidor. O que depende de terceiro entra no prazo como espera. 4. Precisa de movimento real para confirmar? Se precisa, o prazo inclui esperar esse movimento chegar.
Para quem essa conta serve — e quando não se aplica?
Ela serve bem nos seguintes casos:
Dono de negócio que quer saber se um ajuste cabe na semana ou no mês.
Quem já tem um sistema rodando e quer consertar uma parte dele.
Quem vai montar algo que precisa rodar sozinho, como publicação ou cadastro automático.
Ela não se aplica bem quando o projeto depende de aprovação de fora, como a revisão de uma plataforma grande. Aí o prazo não é seu, e nenhuma régua interna prevê.
Também não serve para quem quer um número fechado antes de saber o tamanho da peça. Sem diagnóstico, qualquer prazo é chute.
O que a gente faria no seu lugar?
Nós mediríamos o prazo pelas rodadas de revisão, não pela velocidade da IA. O motivo está nos dois casos. A escrita e a correção levaram minutos. O que separou 1 dia de 20 dias foi quantas vezes o resultado precisou ser conferido.
Começaríamos pelo conserto pequeno, com causa clara, antes do sistema grande. O caso do CRM mostra por quê: em 1 dia dá para ter uma entrega provada em produção.
O que não faríamos: prometer “fica pronto amanhã” para algo que precisa rodar sozinho. E não contaríamos como pronto o código que funcionou uma vez na tela de teste.
Em resumo
O tempo real não depende da IA, depende de quantos ciclos de revisão a peça exige antes de virar produção. É 1 dia quando é um diagnóstico e uma correção. São semanas quando é um sistema que precisa provar que roda sozinho, repetidas vezes, sem supervisão constante.
Quem estima prazo olhando só “quanto tempo a IA leva pra escrever” costuma errar pra menos.
Uma automação pode estar 100% pronta no código e ainda não funcionar, porque a trava não é técnica, é de permissão da plataforma. Construí um agente que lê comentário, responde publicamente e tenta enviar mensagem privada no Instagram. As duas primeiras funcionam; a terceira trava com o erro “Application does not have the capability”: falta a revisão formal da Meta.
O código pode estar pronto e mesmo assim não passar: a liberação depende da autorização da plataforma.
Isso não é exclusivo do Instagram. É um padrão comum: uma parte da automação pede acesso a algo sensível (mensagem privada, dado financeiro, publicação em nome de outro). A plataforma exige que um humano da empresa dona da API (a porta que um sistema abre para outro conversar com ele) aprove esse acesso antes de liberar, mesmo com o código certo.
O que funcionou de verdade nessa automação?
Duas das três etapas funcionaram sem barreira nenhuma. Ler os comentários de um post (`GET /{media-id}/comments`) funcionou de primeira.
Responder um comentário publicamente (`POST /{comment-id}/replies`) também funcionou. Foi testado ao vivo em comentários reais, e a resposta apareceu publicada normalmente.
O código foi escrito com o Claude Code — a ferramenta da Anthropic que escreve e roda programas a partir de pedidos em português. A parte técnica não foi o gargalo.
Onde exatamente ela travou?
A terceira etapa era enviar uma mensagem privada em resposta ao comentário. O recurso se chama “Private Reply”, via `POST /{ig-id}/messages`. Ele retornou o erro de código 3: “Application does not have the capability”.
O token — a chave digital que prova que o app pode agir pela conta — já tinha as permissões `instagram_manage_messages` e `instagram_manage_comments`. Elas estavam concedidas em nível básico. Isso não bastou.
Por que a Meta bloqueia isso mesmo com o código certo?
Porque enviar mensagem privada em nome de uma conta empresarial é uma permissão de acesso avançado. E acesso avançado exige passar pelo App Review da Meta.
O App Review é a revisão em que a equipe da plataforma analisa o uso pedido. Geralmente pede a descrição do caso de uso e uma gravação de tela mostrando a função funcionando. Segundo a própria Meta, ela testa o app de verdade: se não conseguir acessá-lo para testar, a submissão inteira é recusada.
Uma tentativa de contorno que não funciona: inscrever a página no campo de eventos de mensagem (`subscribed_apps`) direto, sem passar pela revisão. Isso retorna outro erro (código 200). Esse caminho pertence ao Messenger do Facebook, não ao Instagram. São sistemas de permissão diferentes por baixo.
Qual é o problema que quase ninguém conta?
A trava não para na mensagem privada. Ela chega antes, no aviso de comentário novo.
Para responder sozinha, a automação precisa ser avisada de que alguém comentou. Esse aviso automático se chama webhook (um “toca a campainha” que a plataforma manda para o seu sistema quando algo acontece).
A documentação de webhooks do Instagram diz, com todas as letras: “Advanced Access is required to receive comments and live_comments webhook notifications”. Ou seja: sem acesso avançado, o aviso de comentário não chega.
No nosso caso, o sistema estava todo ligado. O teste manual do painel da Meta chegou ao sistema. Mas nenhum comentário real disparou aviso. Cadastrar uma segunda conta como “testadora” do app também não resolveu: o comentário dela não gerou aviso nenhum.
A mesma página traz mais duas exigências. O app precisa estar no modo Live (publicado, e não em desenvolvimento). E a empresa por trás do app precisa ter passado pela verificação de negócio da Meta.
Como destravar, passo a passo?
Pelo que as páginas oficiais da Meta exigem, a ordem é esta:
1. Verificar a empresa. A Meta exige verificação de negócio para qualquer app que peça acesso avançado. Confira se o app está no portfólio da empresa verificada. No nosso caso, o app estava num portfólio sem verificação, e esse foi o primeiro passo a corrigir. 2. Pedir só o que usa. A Meta avisa que pedir permissão desnecessária é um motivo comum de recusa. Para comentário e mensagem, são as duas permissões citadas acima. 3. Gravar o vídeo. Mostre o fluxo completo: alguém comenta, a automação responde, a mensagem sai. 4. Deixar o app acessível para teste. Sem isso, a revisão reprova tudo de uma vez. 5. Colocar o app em Live depois da aprovação, para os avisos começarem a chegar.
Quando a revisão ainda não saiu, o que dá para fazer?
A saída foi separar o que já funciona do que depende de terceiro. Publicar a resposta automática no comentário, que já estava liberada, sem prometer, no texto dessa resposta, que uma mensagem privada viria em seguida.
Prometer algo que ainda depende de aprovação externa é o tipo de promessa que o próprio processo pode não cumprir no prazo que a pessoa espera. No lugar, a resposta pública aponta para o link do perfil.
Em paralelo, a revisão formal da permissão pode ser solicitada. Ela não bloqueia o resto da automação enquanto está em análise, só a etapa específica de mensagem privada.
está montando o próprio sistema de “comentou, recebeu mensagem” usando a API da Meta direto;
já tem o código funcionando nos testes, mas nada acontece com comentário de gente de verdade;
quer usar a mesma lógica em outra ação sensível, como publicar em nome de outra conta.
Não se aplica para quem:
usa uma ferramenta pronta que já passou pela revisão da Meta. Nesse caso, a ferramenta já tem o acesso avançado, e você só conecta a sua conta;
só quer ler comentários e responder em público, com a automação indo buscar os comentários de tempos em tempos (em vez de esperar o aviso). Isso funcionou em nível básico no nosso teste;
não tem empresa verificada nem pretende verificar. Sem isso, o acesso avançado não sai.
O que a gente faria no seu lugar?
A gente começaria pela papelada, não pelo código. Antes de escrever uma linha, conferiria se a empresa está verificada e se o app está no portfólio certo.
O motivo é o nosso próprio caso: o código ficou pronto e provado, e mesmo assim nenhum aviso de comentário chegou. A trava estava na permissão, não no programa.
Enquanto a revisão não sai, a gente colocaria no ar só a resposta pública, sem prometer mensagem privada. O que funciona hoje entrega valor hoje.
O que a gente não faria: gastar dias tentando contornar a revisão. Inscrever a página por outro caminho e cadastrar conta testadora foram testados aqui, e nenhum dos dois funcionou.
Em resumo
Código pronto não é o mesmo que automação liberada: quando a ação envolve dado sensível de terceiro — como mensagem privada em nome de uma empresa —, a plataforma dona da API exige revisão humana antes, independente de o código estar certo. A saída não é insistir tentando contornar: é separar o que já funciona hoje do que depende de aprovação externa, e não prometer o que ainda não foi liberado.
Dá para montar um CRM (sistema que organiza contatos e vendas) completo sem contratar desenvolvedor, partindo de código-fonte pronto e ajustando com IA — o gasto real vira infraestrutura, não mão de obra. Hoje isso custa R$43,99 por mês de aluguel do computador onde ele roda, dividido com outros dois sistemas. O resto do custo foi tempo, não dinheiro.
Construir saiu barato. O risco de verdade estava no que já existia no ar e não tinha cópia em lugar nenhum.
Não teve orçamento de agência nem fatura de freelancer. O sistema roda em produção há semanas, atendendo leads de verdade. Lead é a pessoa que deixou o contato e pode virar cliente. E o que ele custou de fato só ficou claro depois de rodar por um tempo, não no dia em que “ficou pronto”.
O que significa construir sem contratar desenvolvedor?
Significa partir de um código-fonte que já existe e ajustar, corrigir e estender esse código com IA. Nesse caso, a base foi um template (um modelo pronto) de CRM já usado por outra operação. A ferramenta foi o Claude Code, uma IA que escreve e roda o código. Não se abriu vaga nem se contratou por job.
O ponto não é “a IA escreveu tudo do zero sozinha”. É que não existiu curva de aprendizado de linguagem nem reunião de escopo com terceiro. O pedido virava código no mesmo dia, testado na hora.
Quanto custa de infraestrutura, de verdade?
O único custo recorrente e mensurável é o servidor (o computador ligado 24 horas onde o sistema fica no ar). No caso, um VPS (servidor virtual privado: um pedaço de um computador grande, alugado só para você) de nível básico.
O plano KVM 2 na Hostinger custa hoje R$43,99 por mês na tabela oficial, com preço promocional aplicado. Esse valor não é exclusivo do CRM. No mesmo servidor rodam mais dois processos além dele, dividindo o custo sem dividir a fatura.
Item
Custo
Servidor (VPS, plano básico)
R$43,99/mês (tabela atual)
Mão de obra de desenvolvedor
R$0 — nenhuma contratação
Licença de banco de dados
R$0 — SQLite (banco de dados que cabe num arquivo só), sem custo de licença
Tempo de configuração inicial
1 sessão de trabalho, num único dia
O que quebrou no meio do caminho?
Duas coisas quebraram de verdade, e nenhuma delas era o código do CRM em si.
A primeira foi uma peça pronta de que o sistema depende. A biblioteca que lê e grava o banco de dados local (better-sqlite3) não tinha versão pré-compilada (já montada, pronta para usar) para a versão mais nova do Node.js (o motor que faz o sistema funcionar). Então tentou se montar na hora. Isso exige um compilador C++ que não estava instalado.
O conserto foi trocar para a versão mais recente da mesma biblioteca. Ela já vem pré-compilada e não depende de compilador nenhum. Fica o aviso: se um dia o Node.js for trocado de versão, o mesmo tropeço pode voltar.
A segunda foi mais séria. O código baixado para editar localmente não era um repositório Git de verdade (o histórico organizado de todas as versões do código). Era só um arquivo compactado.
E o servidor de produção tinha etiquetas de cliente, como “cliente ativo” ou “cancelado”, que não existiam em nenhuma cópia fora dele. Subir o código local por cima do servidor, sem checar isso antes, teria apagado essas etiquetas sem deixar rastro.
Por que não dá para confiar em produção sem repositório de código organizado?
Porque ninguém sabe ao certo o que existe só lá. Essa foi a lição que ficou. Antes de qualquer envio de código para um servidor em produção, o primeiro passo virou olhar o que já existe lá. Histórico de versão, configuração, dado que não está em lugar nenhum fora daquele servidor. E nunca sobrescrever sem comparar.
Um exemplo menor do mesmo tipo de problema: seis de sete formulários de captura de lead estavam configurados sem etiqueta de entrada. Isso só apareceu quando alguém contou manualmente — apenas dois de sete leads estavam etiquetados na tela. Não era bug de código, era configuração vazia que ninguém tinha ido conferir.
Como subir uma mudança sem apagar o que já está no ar?
O roteiro de atualização que ficou documentado tem uma ordem fixa. Nenhum passo pula o anterior:
1. Olhar antes de tocar. No servidor, conferir o histórico e o que mudou lá desde a última versão. Alguém pode ter ajustado algo à mão. 2. Fazer cópia de segurança do banco de dados. Se der errado, há para onde voltar. 3. Trazer a versão nova do código, só depois de comparar com o que está lá. 4. Aplicar os ajustes na estrutura do banco, quando a versão nova pedir. 5. Reiniciar o sistema e conferir que ele voltou.
Uma regra vale em todos os passos: o arquivo com as senhas do sistema nunca sobe junto. O servidor tem o dele. Cada instalação, inclusive a do computador de quem edita, tem suas próprias chaves e seu próprio banco.
Vale mais montar do zero ou partir de um template pronto?
Partir de um código já existente encurtou o tempo de semanas para um único dia de configuração inicial. Mas trouxe justamente esse tipo de risco: peça escondida de que o sistema depende, dado de produção que a cópia local não tem e comportamento que só o servidor real conhece.
Quando vale esse caminho — e para quem ele não serve?
Ele se aplica bem nos seguintes casos:
Negócio que já tem um CRM de código aberto ou um template para partir, em vez de começar do zero.
Quem aceita pagar em tempo o que deixaria de pagar em mensalidade ou em desenvolvedor.
Quem pode dividir um servidor com outros sistemas, como aconteceu aqui com mais dois processos.
Ele não serve bem para quem precisa de alguém de plantão quando o sistema cai. Aqui, a manutenção é de quem construiu. Também não serve para quem vai mexer em produção sem cópia de segurança e sem olhar o histórico antes. Foi exatamente esse atalho que quase apagou as etiquetas dos clientes.
O que a gente faria no seu lugar?
Nós partiríamos de um template pronto, e não do zero. O motivo é o próprio número do caso: a configuração inicial coube em um dia, e o custo fixo ficou em R$43,99 por mês, dividido com outros dois sistemas.
Mas trataríamos o servidor de produção como a única fonte de verdade desde o primeiro dia. Antes de qualquer envio, olharíamos o histórico e faríamos cópia do banco.
O que não faríamos: subir uma cópia local por cima da produção só porque “no meu computador funciona”. As etiquetas de cliente que só existiam no servidor mostram o preço desse atalho.
Em resumo
Construir um CRM sem contratar desenvolvedor custou, na prática, R$43,99 por mês de servidor compartilhado e uma sessão de configuração. Mas o risco real não estava no código novo. Estava no que já existia em produção e não tinha cópia em lugar nenhum.
Quem for pelo mesmo caminho ganha tempo, mas precisa tratar o servidor de produção como fonte de verdade, nunca a cópia local. Mais sobre o custo de manter esse tipo de sistema rodando com IA está em quanto custa usar o Claude Code no Brasil, em real, por mês.
Dá, cruzando três peças: o WhatsApp oficial, que define o que pode ser enviado e quanto custa; uma ligação real com a agenda — Google Agenda ou equivalente — que devolve o horário livre; e um motor que entende linguagem solta, não só menu de botão. É essa terceira peça que resolve “sexta de manhã, depois das 14h”.
O atendente conversa com o cliente, consulta a agenda de verdade e encaixa o horário livre, enquanto você segue trabalhando.
Quem agenda por telefone ou WhatsApp manual conhece o padrão. Pergunta o dia, confere a agenda numa aba separada, digita a resposta. E faz isso de novo pra cada remarcação. O trabalho não é decidir o horário. É ficar de ponte entre a conversa e a agenda.
Quais são as três peças desse atendente?
Nenhuma substitui a outra.
Peça
Função
Canal — WhatsApp oficial
define o que pode ser enviado sem o cliente ter escrito antes e cobra por mensagem — desde 1º de outubro de 2026, também dentro da janela de 24 horas
Agenda — Google Agenda ou equivalente
fonte real do horário livre, consultada a cada resposta — nunca planilha decorada ou cabeça de alguém
Motor de resposta
fluxo fixo de botão ou agente de IA que lê texto livre — é aqui que o resultado muda
As duas primeiras peças são infraestrutura. A terceira é a decisão que este artigo detalha.
Por que um menu de botão fixo não dá conta de “sexta de manhã, depois das 14h”?
Porque a própria WhatsApp Business Platform limita o que um menu pode oferecer. Um botão de resposta rápida aceita no máximo 3 opções, com rótulo de até 20 caracteres. Uma lista aceita mais itens, mas até 10 linhas somando todas as seções. Não dá pra listar todo horário livre do mês.
Por isso o fluxo de botão precisa quebrar a escolha em etapas: primeiro o serviço, depois o dia, depois um horário dentre no máximo 10.
Cliente que digita “sexta de manhã, mas só depois das 14h” não bateu em nenhuma opção. O fluxo trava ou joga pra atendimento humano. É a limitação estrutural que separa regra fixa de agente com linguagem natural.
Como o agente sabe qual horário está realmente livre?
Ele consulta a agenda antes de responder, em vez de adivinhar.
Para isso usa uma API (a porta que um sistema abre para outro conversar com ele). No caso, a API de disponibilidade do Google Agenda, que o Google abre para a agenda ser consultada. Ela recebe um intervalo de tempo e devolve só os períodos ocupados — sem título de compromisso, sem detalhe. Aceita até 50 agendas numa única consulta.
Isso é o que permite ao agente cruzar “sexta de manhã, depois das 14h” com o que está realmente livre naquele dia. Ele não oferece um horário da lista pronta que já foi tomado. O fluxo de botão também pode consultar essa mesma API — a diferença não está na agenda, está em quem interpreta o pedido.
Dá para remarcar e cancelar do mesmo jeito que marcar?
Remarcar é mais difícil que marcar, porque exige achar um compromisso que já existe, não só abrir um vazio na agenda.
Num fluxo de botão, isso normalmente vira mais uma etapa fixa: “digite 1 para ver seus agendamentos”. Um agente que lê texto livre interpreta “quero mudar minha sexta pra semana que vem” direto. Ele localiza o evento vinculado àquele número de telefone e chama a atualização na agenda sem passar por menu.
A trava técnica é a mesma nos dois casos: o compromisso precisa estar identificado — telefone ou nome do cliente no próprio evento. Senão, nem o agente mais esperto acha o que remarcar.
Como funciona o lembrete que chega um dia antes?
Aqui a regra é igual pro fluxo de botão e pro agente de IA, e é o ponto que mais gente esquece. Se o cliente não escreveu nas últimas 24 horas, a mensagem só pode sair como modelo de utilidade pré-aprovado pela Meta. É um texto fixo, com variáveis no lugar de nome, data e hora.
Mesmo o agente mais flexível não pode improvisar essa mensagem à vontade. O modelo pode incluir um botão de resposta rápida, como “Cancelar”, exatamente como no exemplo de confirmação de reserva da própria documentação da Meta. A liberdade de conversar em texto livre vale para o resto da conversa. Não vale para o disparo que a empresa faz por iniciativa própria.
Quando a conversa na janela de 24 horas passou a custar?
Em 1º de outubro de 2026. Até 30 de setembro de 2026, toda mensagem de texto livre dentro da janela de 24 horas era grátis. A própria Meta confirma a mudança: desde essa data, a mensagem de sessão é cobrada por unidade, no mesmo valor do modelo de utilidade daquele país.
Na prática, isso pesa mais sobre um agente que negocia em várias mensagens do que sobre um menu de botão enxuto. Cada rodada de “não pode esse horário, e esse aqui?” vira uma mensagem paga a mais. Detalhamos a conta completa em quanto custa o agente de IA do WhatsApp Business por mês.
O dado da minha agenda fica exposto nesse fluxo?
Menos do que parece. A consulta de disponibilidade do Google Agenda tem uma permissão específica, mais restrita que o acesso completo — `calendar.events.freebusy`. Ela devolve só os intervalos ocupados, sem abrir o conteúdo dos outros compromissos.
Isso limita o que vaza mesmo se a integração for mal configurada. O que continua sob sua responsabilidade é o histórico de conversa do cliente — nome, telefone, serviço marcado. Ele segue a mesma lógica de qualquer ferramenta com dado de terceiro, tratada em é seguro usar IA com os dados dos meus clientes.
Dá para montar isso sem contratar programador?
Dá, e a montagem tem as mesmas três peças de sempre: o número na plataforma oficial, a agenda ligada por API, e a regra que decide o que responder.
Existem três caminhos honestos pra chegar lá:
Ferramenta pronta de agendamento com IA, com o fluxo já montado
Automação visual, ligando as peças numa plataforma como n8n ou Make
Construção sob medida, escrevendo a integração com a API oficial e a API do Google Agenda usando uma ferramenta de linha de comando com IA, como o Claude Code
O que muda entre os três é o quanto você controla a lógica de “o que fazer quando o horário pedido não existe”. E é aí que mora a diferença entre o fluxo de botão e o agente de linguagem livre.
O que dá errado com mais frequência nesse tipo de atendente?
Duas falhas aparecem com mais frequência. A primeira é o agendamento duplo: dois clientes escolhendo o mesmo horário quase ao mesmo tempo. Acontece quando o agente não confere a agenda de novo bem antes de confirmar.
A segunda é o agente confirmar um horário sem checar a agenda de verdade. Ele responde com uma disponibilidade plausível, mas não verificada, porque a consulta à agenda falhou ou foi pulada. É rara nas duas primeiras semanas e comum quando o volume de conversas cresce.
Para quem o atendente que agenda sozinho se aplica bem — e quando não?
Se aplica bem a quem marca horário com duração previsível e já usa uma agenda digital. A consulta de disponibilidade só funciona se a agenda for a fonte real do horário livre.
Também serve a quem recebe pedidos em texto solto, do tipo “sexta de manhã, depois das 14h”. É exatamente o caso em que o menu de botão trava, pelos limites de 3 botões e 10 linhas.
Não se aplica bem quando a agenda mora num caderno ou na cabeça de alguém. Sem fonte real, o agente confirma horário que não existe — a segunda falha da seção anterior. E, para poucos horários por semana, um menu de botão enxuto resolve e gasta menos mensagens pagas.
O que a gente faria no seu lugar?
A gente montaria o atendente no WhatsApp oficial, com a agenda consultada a cada resposta. E colocaria uma segunda checagem da agenda logo antes de confirmar. É o conserto direto do agendamento duplo.
A gente escolheria o agente de IA só se os clientes pedem horário em texto solto. Se eles escolhem entre poucas opções, o menu de botão basta. E, desde 1º de outubro de 2026, cada rodada de negociação é uma mensagem paga.
O que a gente não faria: deixar o agente confirmar horário quando a consulta à agenda falhou. Nem usar planilha decorada como fonte de horário livre.
Em resumo
Um atendente que agenda sozinho precisa de canal oficial, agenda consultada em tempo real e um motor que entenda o pedido do jeito que o cliente escreve. O que separa um fluxo de botão de um agente de IA não é a agenda nem o WhatsApp — é a capacidade de interpretar “sexta de manhã, depois das 14h” sem forçar o cliente a navegar um menu.
Fontes: as regras de mensagem de sessão, janela de 24 horas, limites de botão e lista, modelo de utilidade e a mudança de 1º de outubro de 2026 vêm da documentação oficial da WhatsApp Business Platform (Meta for Developers); a consulta de disponibilidade vem da referência da API do Google Agenda (Google for Developers); a distinção técnica entre fluxo de regra fixa e agente de IA segue a definição da IBM, linkada acima. O cruzamento entre as três fontes e a leitura sobre o que muda na prática são da Apare as Pontas.
O Claude Code vem dentro dos planos Pro (US$ 20/mês) ou Max (US$ 100 ou 200/mês) da Anthropic, cobrados só em cartão internacional, em dólar. A fatura soma IOF (imposto sobre compra no exterior) de 3,5% e o spread do banco, de quase zero a 6%. Um Pro de US$ 20 sai entre R$107 e R$112, não R$102.
O preço em dólar chega à fatura com duas mordidas no caminho: o imposto e a taxa do banco.
Quanto custa o Claude Code na tabela oficial da Anthropic?
A Anthropic vende o Claude Code embutido nos planos de assinatura — não é um produto vendido à parte.
O Pro custa US$ 20/mês, ou US$ 17/mês pagando o ano inteiro à vista. O Max sai por US$ 100 ou US$ 200/mês, com 5x ou 20x mais uso. O Team custa de US$ 20 a 25 por assento/mês. Todos incluem o Claude Code, conforme a página oficial de preços.
Por que o valor que sai no cartão nunca é a conversão simples da cotação?
Porque a Anthropic cobra em dólar, e quem converte pra real não é ela — é o emissor do seu cartão.
Esse processo tem duas etapas que a conversão “de cabeça” (preço em dólar vezes cotação comercial) não mostra. Primeiro, o banco aplica um spread cambial próprio — uma margem escondida na conversão do dólar — em cima da cotação do dia. Depois, incide o IOF sobre o valor já convertido.
Por isso a conta simples sempre fica abaixo do que aparece na fatura de verdade.
Quanto é o IOF cobrado numa compra internacional no cartão de crédito?
3,5% sobre o valor de cada compra, lançado direto na fatura.
Essa alíquota está unificada desde julho de 2025, quando o Supremo Tribunal Federal restabeleceu o Decreto nº 12.499/2025. Antes disso, cartão de crédito, débito e pré-pago tinham percentuais diferentes entre si, variando de 1,1% a 3,38%. Hoje os três pagam a mesma taxa — segundo o Rádio Câmara, da Câmara dos Deputados e a Wise.
Vale confirmar a alíquota vigente antes de fechar a assinatura — decreto de IOF muda por decisão do governo, sem aviso longo.
Quanto o banco ou a operadora cobra de spread cambial, além do IOF?
Varia muito, e é o item que a maioria nem sabe que existe.
Um levantamento com bancos e fintechs brasileiros mostra spread de 0% em cooperativas de crédito, entre 0,6% e 1% em cartões digitais focados em câmbio, e de 4% a 6% em bancos tradicionais como Itaú, Santander, Bradesco e C6 Bank — segundo o ranking do Melhores Cartões.
Esse número some do preço anunciado porque quem decide é o emissor do cartão, não a Anthropic. E pode mudar sem aviso prévio.
Dá para pagar o Claude Code em real, direto com a Anthropic, sem cartão internacional?
Não, pelo menos não pelo canal oficial.
Segundo o Help Center da Anthropic, assinaturas pagas pelo site só aceitam cartão de crédito ou débito — nada de Pix, boleto ou transferência. Não há preço listado em real na página oficial.
Existem gateways de terceiros (empresas intermediárias de pagamento) revendendo acesso com cobrança em real. Isso fica fora do canal oficial da Anthropic, e troca o risco cambial por outro tipo de risco: depender de um intermediário que não é parte do contrato original.
Quanto sai de verdade por mês, somando tudo?
A tabela abaixo cruza o preço oficial, a conversão simples pela cotação comercial e a faixa realista com IOF e spread somados.
Plano
Preço oficial
Conversão simples*
Faixa realista no cartão
Pro
US$ 20/mês
~R$ 102
R$ 107 a R$ 112
Max 5x
US$ 100/mês
~R$ 512
R$ 535 a R$ 562
Max 20x
US$ 200/mês
~R$ 1.024
R$ 1.070 a R$ 1.123
*Cotação comercial de referência: US$ 1 = R$ 5,12, consultada em 08/09/2026 — confira a cotação do dia antes de fechar a assinatura. A faixa realista soma IOF de 3,5% e um spread entre 1% (cartão de baixo custo) e 6% (banco tradicional).
A diferença entre a coluna do meio e a da direita é o que nenhuma fonte sozinha mostra: 5% a 10% a mais em cima do preço anunciado, só de imposto e câmbio.
Como reduzir esse custo sem trocar de plano?
Duas alavancas reais, sem depender de a Anthropic mudar nada.
A primeira é o cartão: cooperativas e alguns cartões digitais cobram spread perto de zero, contra 4% a 6% dos bancos tradicionais — essa diferença some direto da fatura, todo mês.
A segunda é o ciclo de cobrança: o Pro anual sai por US$ 17/mês em vez de US$ 20, numa parcela só em vez de doze. Menos conversões cambiais ao longo do ano também reduz a exposição à variação da cotação.
O preço fixo não quer dizer uso sem fim. A página oficial de preços avisa que todo plano tem limite de uso. Esse limite zera numa janela de cinco horas. E os planos pagos ainda somam um limite por semana.
Na prática, o problema aparece assim: você está no meio de uma automação, o limite acaba, e o trabalho para até a janela virar. A mesma página diz que a Anthropic pode limitar o uso de outras formas, como tetos semanais e mensais, a critério dela.
Ou seja, o custo real não é só quanto sai no cartão. É também quanto trabalho cabe dentro daquele valor. Quem usa pouco nunca sente. Quem usa todo dia sente primeiro no Pro.
Quando vale trocar o Pro pelo Max?
Quando o limite do Pro começa a interromper o trabalho com frequência. O Max existe para isso: 5x ou 20x mais uso, por US$ 100 ou US$ 200 por mês.
Na faixa realista do cartão, é sair de R$ 107 a R$ 112 para R$ 535 a R$ 562 no Max 5x. É um salto de cerca de cinco vezes no custo. Por isso, a troca só faz sentido quando a trava de uso já custa mais caro que a diferença.
Se o negócio tem mais de uma pessoa usando, existe ainda o Team. O assento padrão custa US$ 20 por mês no anual ou US$ 25 no mensal. O assento premium custa US$ 100 no anual ou US$ 125 no mensal, segundo a mesma página.
Para quem cada plano se aplica — e quando não vale?
O Pro se aplica bem para quem:
está começando e quer testar uma ou duas automações;
usa a ferramenta algumas vezes por semana, não o dia inteiro;
quer saber o custo real antes de apostar mais alto.
O Max se aplica bem para quem:
já esbarra no limite do Pro com frequência;
constrói e ajusta sistemas quase todo dia.
Nenhum dos dois serve para quem:
precisa pagar em real, por Pix ou boleto. O canal oficial só aceita cartão;
não quer lidar com variação do dólar todo mês. O valor da fatura muda com a cotação e com o spread do banco;
quer uma ferramenta pronta, sem construir nada. Aí vale comparar com os caminhos de n8n e Make citados acima.
O que a gente faria no seu lugar?
A gente começaria no Pro mensal, pago num cartão de spread baixo. O motivo está neste artigo: entre o banco tradicional (4% a 6%) e o cartão de baixo custo (perto de zero a 1%), a diferença pode passar de 5 pontos percentuais, todo mês, sem mudar nada no uso.
Depois de um ou dois meses, com a rotina de uso já clara, a gente decidiria. Se o limite quase nunca trava, passaria para o Pro anual, que cai de US$ 20 para US$ 17 por mês. Se trava toda semana, iria para o Max 5x.
O que a gente não faria: comprar acesso por revendedor só para pagar em real. O risco cambial some, mas entra um intermediário que não faz parte do contrato com a Anthropic. Também não assinaria o Max logo de cara, sem antes saber se o limite do Pro realmente atrapalha.
Em resumo
O preço de tabela do Claude Code é só o ponto de partida. Entre IOF de 3,5% e spread cambial de até 6%, um plano Pro de US$ 20 tende a sair entre R$107 e R$112 por mês na fatura real, não os ~R$102 da conversão simples — e não existe hoje forma oficial de pagar em real, Pix ou boleto direto com a Anthropic.
Você não precisa saber programar. Basta um computador com Windows 10 (1809+), macOS 13+ ou Linux, 4 GB de RAM e internet. A instalação é um único comando colado no terminal (a tela de comandos), seguido de login com uma conta paga da Anthropic — Pro, Max, Team ou Console. Dando certo de primeira, leva menos de 5 minutos.
Começar são três passos curtos: computador, instalação e login. O tropeço mais comum é conhecido e tem saída.
Se você chegou até aqui, já decidiu tentar. A trava não é falta de vontade — é não saber o que abrir primeiro. Terminal, PowerShell, Node.js (um motor que roda programas), WSL (o Linux dentro do Windows): são nomes que assustam quem nunca programou. Nenhum deles exige curso prévio.
O caminho abaixo é o que existe hoje, testado por quem instalou pela primeira vez.
Que sistema operacional e requisitos mínimos eu preciso ter?
Claude Code roda em Windows 10 1809+ (ou Windows Server 2019+), macOS 13.0+, Ubuntu 20.04+, Debian 10+ e Alpine Linux 3.19+. O hardware mínimo é modesto: 4 GB de RAM e processador x64 ou ARM64. Qualquer notebook comprado nos últimos anos serve.
Requisito
Mínimo
Windows
10, versão 1809, ou Windows Server 2019+
macOS
13.0+
Linux
Ubuntu 20.04+, Debian 10+, Alpine 3.19+
RAM
4 GB ou mais
Processador
x64 ou ARM64
Internet
Obrigatória, conexão ativa
Shell
Bash, Zsh, PowerShell ou CMD
Não precisa de placa de vídeo. Nem de servidor (um computador alugado que fica ligado o tempo todo). Também não precisa de plano de internet especial. É o mesmo computador que já roda um navegador com várias abas abertas.
Qual é o comando exato pra instalar no Windows, Mac ou Linux?
O método recomendado hoje é o instalador nativo: um único comando, sem instalador separado e sem precisar de Node.js. Ele muda conforme o terminal que você tem aberto. O erro mais comum é colar o comando errado no lugar errado.
macOS, Linux ou WSL (abra o Terminal):
`curl -fsSL https://claude.ai/install.sh | bash`
Windows, no PowerShell (o prompt mostra `PS C:\`):
`irm https://claude.ai/install.ps1 | iex`
Windows, no CMD (o prompt mostra só `C:\`, sem “PS”):
`curl -fsSL https://claude.ai/install.cmd -o install.cmd && install.cmd && del install.cmd`
Também dá para instalar via Homebrew (`brew install –cask claude-code`) no Mac ou WinGet (`winget install Anthropic.ClaudeCode`) no Windows. No Windows, a página oficial de instalação avisa que não é preciso rodar como Administrador. Depois de instalar, abra uma pasta de projeto e digite `claude` para começar.
Preciso instalar Node.js ou o Git for Windows antes de começar?
Não, se usar o instalador nativo. Ele baixa um programa pronto e não depende do Node.js (um motor que roda programas escritos em JavaScript). Node.js só entra se você preferir instalar via `npm install -g @anthropic-ai/claude-code`. Nesse caminho, a versão exigida é 22 ou superior.
O Git for Windows é diferente: ele é opcional, mas recomendado em Windows nativo. Sem ele, o Claude Code roda os comandos de terminal usando o PowerShell. Com ele instalado, passa a usar o Git Bash. Quem já usa WSL (o Linux que roda dentro do Windows) não precisa do Git for Windows.
Preciso saber programar pra usar o terminal?
Não. O terminal aqui funciona como uma caixa de conversa. Você digita `claude`, descreve o que quer em português e ele executa. Não existe sintaxe de programação pra decorar. Nem comando de terminal pra memorizar além dos da instalação.
A curva real não é técnica, é de hábito. Gente que nunca abriu um terminal de propósito estranha a tela preta nos primeiros minutos. Depois disso, a interação vira conversa comum, do mesmo jeito que digitar num aplicativo de mensagem.
Quem não quer a tela preta de jeito nenhum tem outra porta. A mesma página oficial indica o aplicativo Desktop, que permite usar o Claude Code sem o terminal.
Que tipo de conta eu preciso ter pra fazer login?
Claude Code pede uma conta paga: Pro, Max, Team, Enterprise ou Console da Anthropic. O plano gratuito do Claude.ai não dá acesso. Depois de instalar, rodar `claude` abre o navegador pra você logar.
Se a chave de API (a senha que libera um programa a usar a IA da Anthropic) já estiver configurada, ele pede aprovação dela direto no terminal.
Brasil está na lista de países onde a Anthropic opera. Não existe bloqueio regional pra fazer essa conta. O valor de cada plano, e o que cabe no bolso de quem está começando, é assunto separado — vale a leitura completa antes de escolher o plano.
Onde trava a maioria na primeira instalação?
Cruzando a documentação oficial de erros com relatos de quem instalou pela primeira vez, os mesmos três tropeços se repetem, nessa ordem de frequência. Nenhum deles é falha do computador. São detalhes que ninguém avisa antes.
1. `comando não reconhecido` depois de instalar. O programa foi parar em `~/.local/bin` (ou `%USERPROFILE%\.local\bin` no Windows). Essa pasta não está no PATH (a lista de pastas onde o terminal procura programas), ou o terminal antigo continua aberto. Fechar e abrir um terminal novo resolve na maioria dos casos. 2. PowerShell bloqueia o script (arquivo com uma lista de comandos). A política de execução do Windows recusa rodar scripts. Segundo o guia oficial de solução de problemas, isso pega quem instalou pelo npm, não o comando `irm` do instalador nativo. A correção oficial é liberar pro usuário atual: `Set-ExecutionPolicy -ExecutionPolicy RemoteSigned -Scope CurrentUser`. 3. Confusão entre PowerShell e CMD. Colar o comando de um no outro devolve um erro que não diz o que está errado. A pista é olhar se o prompt mostra `PS C:\` ou só `C:\`.
Por que o erro de PowerShell e CMD engana tanto?
Porque a mensagem de erro fala de outra coisa. A página oficial de instalação traduz as duas mensagens mais comuns:
Mensagem que aparece
O que significa
`The token ‘&&’ is not a valid statement separator`
Você está no PowerShell, mas colou o comando do CMD
`’irm’ is not recognized as an internal or external command`
Você está no CMD, mas colou o comando do PowerShell
Nenhuma das duas diz “terminal errado”. Por isso a pessoa acha que o computador tem defeito. A correção é só trocar o comando pelo do terminal certo.
Como eu confirmo que a instalação deu certo?
Rode `claude –version` num terminal novo. Se aparecer um número de versão — algo como `2.1.211 (Claude Code)` — a instalação funcionou. Se aparecer erro de comando não encontrado, o problema quase sempre é o PATH descrito acima.
Pra um diagnóstico mais completo, rode `claude doctor`. Ele lê a instalação, as configurações e o resultado da última atualização. Depois aponta o que corrigir, sem precisar abrir uma sessão de verdade.
Quando eu preciso atualizar?
Quase nunca, se usou o instalador nativo. Segundo a documentação oficial, ele se atualiza sozinho, em segundo plano. A versão nova passa a valer na próxima vez que você abrir o `claude`.
Quem instalou pelo Homebrew ou pelo WinGet precisa atualizar na mão. No WinGet, o comando é `winget upgrade Anthropic.ClaudeCode`. No Homebrew, `brew upgrade claude-code`. É mais um motivo para quem está começando ficar com o instalador nativo.
Para quem serve: em quais casos isso se aplica bem — e quando não?
Este caminho de instalação se aplica bem nos seguintes casos:
Quem tem um computador próprio com Windows 10 1809+, macOS 13+ ou Linux, e 4 GB de RAM.
Quem já tem ou vai assinar um plano Pro, Max, Team, Enterprise ou Console.
Quem topa abrir o terminal uma vez, colar um comando e fechar.
Não se aplica bem quando:
A pessoa só tem o plano gratuito do Claude.ai. Ele não dá acesso ao Claude Code.
O computador é da empresa e bloqueia instalação. Aí o caminho é falar com quem cuida da máquina antes.
A pessoa não quer ver terminal de jeito nenhum. O aplicativo Desktop é a porta certa.
O que a gente faria no seu lugar?
A gente usaria o instalador nativo, não o npm. O motivo está no próprio guia de erros: o bloqueio de script do PowerShell pega quem instala pelo npm. O instalador nativo ainda se atualiza sozinho e dispensa o Node.js.
A gente também fecharia e abriria um terminal novo antes de testar. É a solução do tropeço mais comum da lista, o `comando não reconhecido`.
O que a gente não faria: sair colando comando de tutorial antigo sem olhar se o prompt mostra `PS C:\` ou só `C:\`. Também não rodaria como Administrador “por garantia”. A documentação diz que não precisa.
Resumo: o caminho em 5 passos
1. Confira se seu Windows, Mac ou Linux bate com os requisitos mínimos da tabela acima. 2. Abra o terminal certo — PowerShell, CMD ou o terminal do Mac/Linux — e cole o comando correspondente. 3. Feche e abra um terminal novo antes de testar, mesmo se parecer que travou. 4. Rode `claude –version` pra confirmar, e `claude doctor` se algo parecer errado. 5. Entre com uma conta Pro, Max, Team ou Console — o login abre sozinho no navegador.
O que muda depois desse passo a passo: você deixa de ler sobre Claude Code e passa a ter ele aberto. Ele fica esperando um pedido em português, dentro de uma pasta de projeto sua.
Dá, e isso está documentado pela própria Anthropic: existe um guia oficial só para quem nunca abriu um terminal (a tela preta de comandos), em português comum. O que a documentação sozinha não resolve é aprovar uma ação sem entender o que ela faz — foi assim que alguém perdeu 11 GB de arquivo pedindo para “limpar uma pasta”.
Você descreve o que quer em português comum e a IA monta. O cuidado é conferir antes de aprovar cada ação.
Por que existe um guia oficial pra quem nunca abriu um terminal?
Porque a Anthropic sabia que essa seria a maior barreira. O guia oficial de terminal para novos usuários começa direto: “você pode usar o Claude Code mesmo que nunca tenha usado um terminal antes.”
Ele ensina, passo a passo, a abrir a janela preta que assusta quem nunca viu uma. No Mac, pelo Spotlight (a lupa de busca). No Windows, pelo menu Iniciar. Tudo isso antes mesmo de instalar qualquer coisa.
E deixa uma porta de saída. Quem não quer nem chegar perto do terminal pode usar o aplicativo desktop (o programa com janela e botões, igual a qualquer outro). Ele pula essa etapa por completo.
Como funciona pedir uma tarefa sem saber nenhum comando?
Você escreve o que quer, do jeito que fala. A documentação chama isso de “plain English”. A versão em português seria simplesmente “descreva o que você quer”.
Um exemplo que o próprio guia usa: *”olha os prints na minha área de trabalho e renomeia cada um pelo que aparece na imagem.”* Sem sintaxe (a gramática rígida das linguagens de programação), sem comando decorado.
O guia de primeiros passos reforça o mesmo ponto com outro exemplo. Ele pede para criar uma tabela num banco de dados (o arquivo organizado onde o sistema guarda informação). Depois, uma página que mostra e edita esse dado. Tudo em frases soltas, uma de cada vez.
O sistema pergunta antes de mexer nos meus arquivos, ou faz sozinho?
Pergunta, por padrão. Segundo a documentação de permissões, toda edição ou criação de arquivo pede sua aprovação antes de acontecer. Você vê a mudança e escolhe “sim” ou “não”.
Tipo de ação
Pede permissão?
Ler um arquivo
Não
Editar ou criar arquivo
Sim, sempre
Rodar um comando no terminal
Sim, com exceção dos comandos só de leitura
Buscar algo na internet
Sim
Existe um modo que pula essas perguntas, chamado *auto mode* ou *bypass*. Ele é pensado para quem já sabe o que está fazendo. A própria Anthropic recomenda usá-lo só em ambiente isolado, nunca como primeiro contato.
Onde a promessa “não precisa programar” esbarra na prática?
No pedido vago. Um guia independente escrito por Carl Vellotti para não-programadores resume assim: “seu gargalo nunca vai ser sintaxe, vai ser verbo impreciso.”
O caso que ele documenta aconteceu em janeiro de 2026. Alguém pediu para o Claude “limpar” uma pasta. O sistema perguntou. A pessoa aprovou sem ler o que estava sendo apagado. E 11 GB de arquivo foram embora — incluindo alguns que importavam.
O ponto não é que a permissão falhou. Ela pediu, exatamente como a documentação promete. O ponto é que perguntar só protege quem lê a pergunta.
Por que a própria Anthropic lançou um produto sem terminal nenhum?
Porque o terminal continua sendo barreira para muita gente, mesmo com instrução em português. A resposta da empresa foi o Cowork. É uma versão do mesmo motor que roda dentro do chat, sem linha de comando.
O dado é da própria Anthropic, publicado no blog oficial sobre como as pessoas usam o Cowork. Em 1,2 milhão de sessões analisadas, só 8,7% eram desenvolvimento de software. O maior uso, 33,4%, foi processo e operação de negócio. É a categoria mais próxima de “dono de negócio resolvendo trabalho manual”.
Isso não é dado do Claude Code (o terminal); é do Cowork, produto separado. Mas revela algo que nenhuma página de marketing diz de forma direta. A própria Anthropic apostou que a maioria de quem quer automatizar trabalho não quer nem ver uma linha de comando. Por isso construiu uma porta sem ela.
Preciso já ter um “projeto de código” pronto pra começar?
Aqui duas páginas oficiais da Anthropic dizem coisas com ênfase diferente. O guia de primeiros passos lista “um projeto de código para trabalhar” como pré-requisito. É uma frase que assusta quem está começando do zero.
Já o guia voltado a iniciantes é explícito no sentido contrário: “se você ainda não tem um projeto, tudo bem. O Claude pode ajudar você a começar um novo.”
Não é contradição — é público diferente. Quem nunca programou está no público do segundo guia, não do primeiro. A resposta que vale é: não precisa ter nada pronto.
Como eu me protejo do erro que já aconteceu com outra pessoa?
Trabalhando numa pasta só para isso, e nunca deixando o pedido em aberto. Três frases que o próprio Vellotti recomenda incluir na instrução, direto:
“Me mostra um plano antes de mudar mais de um arquivo” — força o sistema a explicar a intenção antes de agir
“Nunca apaga arquivo. Move para uma pasta chamada `_arquivo_morto`” — troca exclusão por um passo que dá para desfazer
“Não apaga nada” — dito assim, sem meio-termo, quando o pedido envolver organizar ou limpar algo
Nenhuma dessas frases exige saber programar. Exige só não aprovar uma ação sem ler o que ela descreve. Foi esse o hábito que faltou no caso dos 11 GB.
Quando vale testar antes de contratar um programador?
Para uma tarefa pontual, sim. O custo de errar é baixo, porque o sistema pede aprovação antes de qualquer mudança. A assinatura de entrada gira perto de R$ 100 por mês. O valor está detalhado, com tabela completa, em Claude Code ou ChatGPT: qual usar para automatizar meu negócio?
O que muda depois de testar é a pergunta que você faz. Deixa de ser “isso é coisa de programador?”. Vira “o que eu preciso automatizar que hoje eu faço na mão, toda semana?” — a mesma pergunta por trás de Claude Code ou n8n/Make: qual resolve a automação do meu negócio?
E se algo sair do previsto no meio do caminho, vale ler o que dá errado quando um agente de IA atende no WhatsApp antes. Os erros que mais aparecem não são de programação. São de instrução mal dada, exatamente como no caso dos 11 GB.
Para quem serve: em quais casos isso se aplica bem — e quando não?
Usar o Claude Code sem saber programar se aplica bem nos seguintes casos:
Tarefa com arquivos no seu computador, como renomear, organizar ou montar uma planilha — o tipo de exemplo que o próprio guia oficial usa.
Quem topa ler cada pergunta de permissão antes de dizer “sim”. É isso que a proteção exige.
Quem trabalha numa pasta separada, feita só para os testes.
Não se aplica bem quando:
A pessoa não quer ver terminal de jeito nenhum. Aí o aplicativo desktop ou o Cowork são a porta certa, e a própria Anthropic construiu o Cowork para esse público.
Alguém quer ligar o modo que pula as perguntas logo no primeiro dia. A Anthropic recomenda esse modo só em ambiente isolado.
A pasta tem arquivo único, sem cópia de segurança. Um pedido vago ali pode custar o que custou os 11 GB.
O que a gente faria no seu lugar?
A gente começaria, sim, sem saber programar. Mas com uma regra fixa: nenhum “sim” sem ler a pergunta inteira. O caso dos 11 GB mostra que o risco não é técnico. A permissão funcionou; quem falhou foi a leitura.
A gente também escreveria as três frases de proteção do Vellotti no primeiro pedido, antes de qualquer tarefa. Custa uma linha e troca “apagar” por “mover”.
O que a gente não faria: ligar o *auto mode* para “ganhar tempo” no começo. E não começaria pela pasta de trabalho de verdade. Primeiro, uma pasta de teste, com cópia de tudo.
Em resumo
Dá para usar o Claude Code sem saber programar. A documentação oficial confirma, com guia próprio para quem nunca viu um terminal, instrução em português e permissão pedida antes de cada mudança.
O que nenhuma dessas garantias substitui é ler o que está sendo aprovado antes de dizer sim. Foi a falta desse hábito, não a falta de conhecimento técnico, que custou 11 GB a quem já testou.
Dá para automatizar quase tudo: um script (pequeno programa) na nuvem chama a API (a porta de dados) de cada fonte uma vez por dia — rede social, anúncio, vendas — e grava os números numa planilha. Mas sempre sobra um número que nenhuma API entrega, e o sistema certo assume essa fresta em vez de fingir automação total.
Quase todos os números chegam sozinhos ao painel. Sempre sobra um que precisa de conferência humana.
Qual é o problema por trás dessa pergunta?
Talvez você abra três abas diferentes toda manhã: uma rede social, o painel de anúncio, talvez uma planilha de vendas. Tudo isso só para copiar três ou quatro números numa quarta aba. Se é assim, você já sentiu o problema na pele.
Não é o trabalho de copiar em si que cansa. É o fato de ser todo dia, sempre o mesmo gesto, sempre a mesma chance de errar um dígito ou esquecer de atualizar.
E, no fundo, incomoda mais ainda uma coisa que ninguém te disse. Até esse trabalho manual pode estar produzindo número errado, e você não teria como saber.
Como funciona, por trás dos panos, uma automação que junta números de fontes diferentes?
O desenho é sempre parecido. Um script acorda uma vez por dia, chama a API de cada fonte, pega os números que interessam e escreve numa planilha ou num banco. Pode ser um pedacinho de código rodando numa nuvem gratuita, sem precisar manter um servidor (um computador ligado o tempo todo).
A planilha vira só a “tela” que mostra o resultado. Quem faz o trabalho pesado é o script.
A parte que costuma faltar na cabeça de quem nunca fez isso: API não é um espelho perfeito do que aparece na tela do aplicativo. Cada plataforma decide o que expõe, em que formato e com que atraso. Duas fontes que “deveriam” combinar direto quase sempre exigem um ajuste no meio.
O que uma API realmente entrega, e por que ela é a porta e não a fonte?
API é a porta pela qual um programa conversa com o sistema de outra empresa, sem passar pela tela que uma pessoa usaria. Ela devolve exatamente os campos que o fornecedor decidiu documentar — nem um a mais.
A suposição mais comum é errada: “se o número aparece no aplicativo, ele sai pela API”. Na prática, o aplicativo tem métricas de tela que a API nunca expõe. Às vezes é decisão de produto. Às vezes é limite técnico do formato de conteúdo. Às vezes aquele dado nunca foi liberado para uso automatizado.
Só se descobre testando. A documentação raramente avisa a lacuna antes de você bater nela.
Por que dois números “quase iguais” podem medir coisas diferentes?
Uma conta de anúncio quase sempre roda mais de um tipo de campanha ao mesmo tempo. Uma serve para atrair gente nova. Outra serve para reimpactar quem já demonstrou interesse. A API expõe um campo para o gasto total da conta e outro (ou um filtro) para o gasto de um tipo específico.
São dois números válidos, corretos dentro do que descrevem. Mas imagine que o seu painel precisa de “gasto de aquisição” e o script somou o total da conta. O número final sai inflado, sem nenhum aviso de erro na tela. É o erro mais caro desse tipo de automação, porque ele não avisa que aconteceu.
Que dado nunca dá para automatizar 100%, e por quê?
Nem todo número tem um caminho de API. Alguns motivos reais, documentados pelos próprios fornecedores, para uma métrica não sair automaticamente:
Limite por formato de conteúdo: uma métrica pode existir para foto estática e não existir para vídeo curto. A plataforma mede o comportamento do público de um jeito diferente em cada formato — e simplesmente não processa aquele cruzamento pro segundo caso.
Métrica descontinuada ou nunca liberada: o fornecedor decide, por política própria, o que sai pela API pública. O painel visual do aplicativo pode mostrar mais do que ele libera para automação.
Cálculo que só existe visualmente: alguns números são compostos na tela, a partir de outros dados, sem que exista um campo único correspondente na API.
Quando isso acontece, a saída honesta é simples. Aquele campo específico fica manual — a pessoa digita um número por dia — e todo o resto segue automático.
Um sistema que promete 100% de automação e não entrega vira motivo de desconfiança. Um sistema que assume a fresta e documenta o motivo se sustenta.
O que fazer quando a automação bate um limite de chamadas da plataforma?
Toda API de peso limita quantas vezes você pode chamá-la num intervalo de tempo. É o chamado limite de taxa (*rate limit*). O padrão documentado é responder com o código 429 (Too Many Requests), que quer dizer “pedidos demais”. Às vezes a resposta avisa quanto tempo esperar. Em exemplos oficiais, uma janela de uma hora aparece com frequência (MDN Web Docs, referência de status HTTP 429).
Na prática, o aviso nem sempre é claro. Um limite estourado pode devolver mensagem de “esse dado não existe”, quando é só a plataforma pedindo para você parar por um tempo. A rotina se resolve sozinha: passado o intervalo, a próxima chamada volta a funcionar.
Uma automação que roda uma vez por dia dificilmente esbarra nisso. O risco aparece só em teste em rajada. É quando alguém chama o mesmo endpoint (o endereço exato de um dado dentro da API) dezenas de vezes seguidas em poucos minutos.
Planilha automatizada ainda é planilha, ou já virou painel?
A diferença não está na aparência, está em quem faz o trabalho de buscar o dado:
Planilha manual
Planilha automatizada
Painel/sistema próprio
Quem busca o número
Uma pessoa, todo dia
Um script, todo dia
Um script, todo dia
Onde o número aparece
Célula digitada
Célula preenchida por fórmula/script
Tela própria, com histórico e gráfico
Erro de digitação
Sempre possível
Eliminado nos campos automáticos
Eliminado nos campos automáticos
Erro de cálculo errado (filtro certo x total)
Só se a pessoa errar a conta
Acontece sem aviso, se o filtro da API estiver errado
O mesmo risco — o filtro tem que estar certo desde a primeira versão
Campo que a API não entrega
Preenchido manualmente, como o resto
Preenchido manualmente, isolado dos automáticos
Preenchido manualmente, isolado, com marcação visível de que é manual
Quando essa planilha automatizada já virou um painel de verdade?
Uma planilha com script por trás já resolve a maior dor do dia a dia: parar de digitar. Só vira sistema quando ganha três coisas. Histórico consultável, alerta de variação fora do padrão e separação clara entre automático e digitado.
“Não sei programar — dá pra ter isso mesmo assim?”
A automação em si — o script chamando a API todo dia — precisa de alguém que escreva ou adapte esse código uma vez. Depois de pronto e funcionando, o uso diário não exige nenhuma linha de código. Você só olha a planilha ou o painel prontos.
O ponto real da objeção não é “programar”, é “quem mantém quando algo mudar”. Plataformas mudam a API sem aviso, e um script que funcionava pode parar do dia para a noite. Essa rota é comparada com outras (sistema pronto, ferramenta de automação visual, ou contratar quem escreva o código) em Claude Code ou n8n/Make: qual resolve automação de negócio.
Vale lembrar também que dado de cliente passando por essas chamadas de API carrega responsabilidade sobre onde fica gravado. Esse ponto está detalhado em é seguro usar IA com dados de clientes.
Um caso real: o dia em que o número saiu errado sem nenhum aviso
Esta automação foi construída para acompanhar o crescimento de um negócio. Um script na nuvem, ligado a uma planilha, chamando a API de uma plataforma de anúncios uma vez por dia. Dois números buscados: o alcance/seguidores atual de uma rede social, e o gasto do dia. Mas só o gasto das campanhas de aquisição, nunca o total da conta.
Na primeira versão, o script somava o gasto total da conta. Esse total incluía também as campanhas de reimpacto (remarketing — anúncio para quem já visitou ou interagiu). Isso inflava o custo por resultado sem nenhum erro na tela. O script rodava, entregava um valor, e o valor estava simplesmente errado.
Um dia registrou R$ 24,46 de gasto quando o valor correto — filtrando só o tipo certo de campanha — era R$ 18,31.
A correção foi filtrar a chamada da API por tipo de campanha antes de somar, nunca pelo total da conta. É o padrão que a computação chama de “entra lixo, sai lixo”: dado de entrada errado produz resultado errado, mesmo com o cálculo tecnicamente correto por cima dele (Wikipedia, “Garbage in, garbage out”).
Por que uma métrica ficou manual mesmo depois de tudo automatizado?
O segundo limite do mesmo caso não foi bug, foi teto da própria plataforma. Uma das três métricas — quantos seguidores um conteúdo trouxe — não é acessível pela API para vídeo curto, só para foto estática. Pedir essa métrica para um vídeo devolve erro dizendo que ela não é suportada para aquele formato.
A solução não foi insistir. Essa métrica ficou manual, e as outras duas seguiram 100% automáticas. É o mesmo princípio do item anterior: assumir a fresta em vez de fingir que ela não existe.
O que aconteceu quando a automação bateu o limite de chamadas de verdade?
Terceiro achado do mesmo caso, numa sessão de teste mais pesada. A conta bateu um limite de chamadas por hora, e o erro parecia dizer que um dado “não existia”. Era throttling puro (a plataforma freando os pedidos), disfarçado de erro de conteúdo.
O limite resetou sozinho em cerca de uma hora. Na rotina diária normal, que faz poucas chamadas, esse teto nunca chega nem perto de ser tocado. O risco existe só quando alguém testa em rajada, chamando o mesmo endpoint muitas vezes seguidas em pouco tempo.
O que muda depois de montar essa automação?
Antes, juntar os três números do dia era abrir aplicativo, abrir painel de anúncio e digitar numa planilha. Todo dia, sem exceção. Depois, dois desses três números aparecem sozinhos antes de a pessoa abrir o computador. Resta digitar só o que a plataforma realmente não entrega.
O tempo poupado não é a única mudança. O número deixa de carregar o risco silencioso de somar a fonte errada. O filtro certo está escrito no script, testado uma vez, sem depender de ninguém lembrar de aplicá-lo à mão todo dia.
Para quem serve — em quais casos isso se aplica bem e quando não?
Se aplica bem nestes casos:
quem copia os mesmos números de duas ou mais plataformas todo dia;
quem roda anúncio com mais de um tipo de campanha e precisa separar o gasto de cada um;
quem aceita um ou dois campos manuais em troca de o resto andar sozinho.
Não se aplica bem quando:
o número que você mais precisa é justamente o que a API não entrega. Aí a automação poupa pouco;
você confere esses números uma vez por mês, não todo dia. O esforço de montar não se paga;
ninguém vai cuidar do script quando a plataforma mudar a API sem aviso.
O que a gente faria no seu lugar?
A gente automatizaria só o que a API entrega com certeza e deixaria o resto manual, marcado como manual. No caso deste artigo, foram duas métricas automáticas e uma digitada. Isso funcionou melhor do que insistir numa que a plataforma não libera para vídeo curto.
A gente conferiria o primeiro resultado do script contra a tela da plataforma, na mão, antes de confiar nele. Foi essa conferência que pegou R$ 24,46 no lugar de R$ 18,31.
O que a gente não faria: somar o gasto total da conta quando a pergunta é gasto de aquisição. E não testaria em rajada numa conta real, porque o erro de limite pode se disfarçar de “dado que não existe”.
Resumo
Automatizar a maioria dos números que vêm de fontes diferentes é viável com um script simples chamando cada API uma vez por dia. Mas quase sempre sobra um dado que a plataforma não expõe, e fingir 100% de automação é pior do que assumir esse campo como manual.
O erro mais caro não é o dado que falta e você percebe. É o dado somado errado — total da conta em vez do filtro certo — que passa sem aviso e derruba a confiança no painel no dia em que alguém confere a conta na mão.
Fontes primárias consultadas: o limite de chamadas em API, conforme a referência de status HTTP 429 da MDN Web Docs; o erro silencioso por dado de entrada incorreto, conforme o verbete “Garbage in, garbage out” da Wikipedia. O caso, os números do bug de gasto e o limite de métrica por formato de vídeo são vivência direta da Apare as Pontas, com rede social, plataforma de anúncio e negócio omitidos por confidencialidade.
Para proporcionar uma melhor experiência, usamos tecnologias como cookies para armazenar e/ou acessar informações do dispositivo. O consentimento com essas tecnologias nos permite processar dados como comportamento da navegação ou IDs exclusivos neste site. O não consentimento ou a revogação do consentimento pode afetar negativamente determinados recursos e funções.
Funcional
Sempre ativo
O armazenamento ou acesso técnico é estritamente necessário para o objetivo legítimo de permitir o uso de um serviço específico explicitamente solicitado pelo assinante ou usuário, ou para o único objetivo de realizar a transmissão de uma comunicação por uma rede de comunicações eletrônicas.
Preferências
O armazenamento ou acesso técnico é necessário para o objetivo legítimo de armazenar preferências que não são solicitadas pelo assinante ou usuário.
Estatísticas
O armazenamento técnico ou o acesso que é usado exclusivamente com objetivos de estatística.O armazenamento ou acesso técnico que é usado exclusivamente para fins de estatísticas anônimas. Sem uma intimação, conformidade voluntária do seu provedor de serviços de internet ou registros adicionais de terceiros, as informações armazenadas ou coletadas apenas com esse objetivo geralmente não podem ser usadas para identificar você.
Marketing
O armazenamento ou acesso técnico é necessário, para criar perfis de usuário para enviar publicidade, ou para rastrear o usuário em um site ou em vários sites com objetivos de marketing semelhantes.