Categoria: Automação

Fluxos que tiram o trabalho manual da rotina do negócio.

  • Como receber um alerta quando o anúncio gasta e não vende — sem deixar a máquina desligar nada sozinha?

    Como receber um alerta quando o anúncio gasta e não vende — sem deixar a máquina desligar nada sozinha?

    Monte um monitor que, uma vez por dia, lê gasto e vendas de cada campanha no dia fechado, compara com uma regra de corte escrita antes de ligar o anúncio e avisa quando ela é atingida. Ele propõe; quem pausa é você. As vendas vêm da plataforma onde o dinheiro entra, não do painel de anúncios.
    Mulher fechando a torneira de um cofrinho que derrama moedas, enquanto um alarme roxo toca ao lado de um gráfico.
    O alerta avisa quando o dinheiro está escorrendo sem venda. Quem fecha a torneira é você, não a máquina.

    Quem anuncia conhece a cena: abrir o painel às onze da noite, ver o gasto subindo e não saber se é hora de desligar ou de esperar. O problema quase nunca é falta de dado. É falta de uma régua decidida antes, e de alguém que leia essa régua todo dia sem ansiedade.

    Por que não deixar o próprio Google ou a Meta pausar sozinhos?

    As duas plataformas oferecem regras automáticas. No Google Ads, as regras automatizadas podem mudar status, orçamento e lance quando uma condição bate, e também podem só enviar os resultados por e-mail.

    A Meta tem o recurso equivalente nas regras automatizadas do Gerenciador de Anúncios.

    O risco de deixar a regra agir sozinha é que ela decide com o número do painel, e o número do painel pode estar errado. Por isso, no nosso monitor, a divisão é fixa: ler e alertar é automático; pausar, mudar lance ou orçamento exige confirmação, mostrando o valor atual e o valor novo lado a lado. Ativar anúncio, nunca.

    Quando o monitor lê os números, e o que ele precisa ler?

    Pouca coisa, mas na ordem certa. A primeira pergunta não é CPC (quanto custa cada clique), CTR (de cada 100 pessoas que viram o anúncio, quantas clicaram) nem impressão (cada vez que o anúncio aparece na tela). É quantas vendas aconteceram de verdade.

    1. A planilha de controle — o registro que você mantém
    2. A plataforma de anúncios — o que o Google ou a Meta dizem que converteu
    3. A plataforma de venda — a página de pagamento, a empresa que processa o cartão, a loja: a fonte da verdade
    4. Se as três divergem, o monitor não decide — pergunta

    Só depois disso entra a conta de gasto contra margem. E a leitura é sempre do dia fechado: gasto e venda não chegam no mesmo momento, e decidir pela parcial da manhã é o erro mais caro dessa rotina.

    O que é a regra de corte, e por que ela tem que ser escrita antes?

    A regra de corte é um teto de gasto combinado antes: o valor que, gasto sem nenhuma venda, encerra o teste. Funciona como o limite que você decide antes de entrar numa loja, para não sair gastando no calor da hora.

    A regra base que usamos é simples. Gastou o equivalente ao que se ganha numa venda e não vendeu? O monitor dispara o alerta de pausa.

    Ela é escrita antes de ligar a campanha porque, depois, a ansiedade negocia. Com o anúncio rodando, sempre parece que falta “só mais um dia”. A régua muda conforme o histórico:

    Situação do produtoRégua aplicada
    Nunca vendeuRégua de teste: gastou o ganho de uma venda sem vender, alerta de pausa
    Vendeu de 1 a 3 vezes e parouRégua de insistência: tolera mais uma ou duas margens antes de cortar
    Já faturou de forma consistenteRégua de caixa, com um limite maior e decidido caso a caso

    Usar a régua de produto novo num produto que já vendeu mata cedo demais o que estava funcionando.

    Como a conversão mal medida engana o alerta?

    Aconteceu com a gente. Numa operação de venda online, o painel do Google Ads mostrava 0 conversões, enquanto a plataforma de venda registrava 1 venda paga de R$ 27,06. A tag de conversão (o pedacinho de código que avisa o painel quando uma venda acontece) estava incompleta. Um alerta que confiasse só no painel teria mandado cortar uma campanha que já tinha vendido.

    Por isso o monitor trata “0 conversões no painel” como pergunta, não como fato. Se a plataforma de venda discorda, quem ganha é ela — e a tag vai para conserto antes de qualquer veredito sobre o anúncio.

    Métrica secundária pode derrubar um anúncio que vende?

    Pode, e é o erro mais comum de quem corta por CTR. Num teste na Meta com um produto digital de entrada, o único anúncio que vendeu (3 compras) tinha CTR de 0,79%, o pior do conjunto. Outro anúncio, com CTR de 3,17%, quatro vezes melhor, vendeu zero. Cortar por CTR teria matado o vencedor.

    Daí saiu a regra de imunidade: anúncio que já vendeu não é julgado por métrica secundária. Mas a imunidade expira — quando ele gasta duas vezes o custo por venda desejado sem uma venda nova, volta a ser julgado como qualquer outro. Para anúncio sem venda, usamos três portões:

    PortãoQuando checarAlerta se
    Não chama atenção1.000 impressões ou maisCTR abaixo de 0,8%
    Clique caro8 cliques ou maisCPC acima do teto e nenhuma venda
    Não convertegasto de 4× o custo por venda desejadonenhuma compra

    Abaixo de 150 impressões ou R$ 5 de gasto, o monitor não julga: ainda não há dado.

    Todo gasto conta como teste?

    Não. Se metade do dinheiro foi para buscas que nada tinham a ver com o produto, o produto ainda não foi testado — foi o público errado que gastou. O monitor desconta esse gasto sujo antes de comparar com a regra de corte, e só dá veredito quando praticamente todo o investimento (95% ou mais) caiu em busca realmente ligada à oferta.

    Sem esse desconto, você mata produto bom por culpa de palavra-chave mal negativada. Negativar é dizer ao Google em quais buscas o anúncio não deve aparecer.

    Quais armadilhas fazem o alerta ler errado?

    Três aparecem sem aviso nenhum na tela:

    • Pausa em vários níveis. Ao importar uma campanha por planilha com tudo marcado como pausado, a pausa fica em quatro camadas: campanha, grupo, palavra-chave e anúncio. Religar só a campanha deixa ela “Ativada” no painel e com zero impressão. Aconteceu em 05/08/2026.

    Diante de zero impressão, a primeira checagem é o status das quatro camadas, antes de mexer em palavra ou lance

    • Configuração que muda sozinha. O Google oferece aplicar recomendações automaticamente, e alguns convites trocam a estratégia de lance. Ao preparar uma das nossas contas, o convite para “otimizar para aquisição de novos clientes” vinha com a opção recomendada que eliminava o teto de CPC. Recomendação automática fica desligada, e a estratégia de lance entra na conferência
    • Verba pulverizada. Com seis anúncios dividindo R$ 10 por dia, cada um levaria cerca de 48 dias para chegar ao terceiro portão. A regra existe, mas nunca dispara. Limitamos a três anúncios ativos por conjunto nesse orçamento

    Como resolver isso com IA, passo a passo?

    1. O que construir

    Um agente de monitoramento: uma rotina escrita e executada com o Claude Code (uma IA que escreve e roda programas a partir de instruções em português). Uma vez por dia, ele lê as métricas das contas no dia fechado, cruza com a plataforma de venda e aplica a régua.

    No fim, devolve um resumo: gasto acumulado, quanto da regra de corte já foi consumido, gasto sujo, vendas e as ações sugeridas, cada uma com motivo. Nenhuma ação de valor ou de pausa sai sem o “pode” de quem é dono do dinheiro.

    2. O pedido pronto para copiar

    O pedido que recomendamos colar no Claude Code:

    “Monte um monitor diário de anúncios que só lê e avisa, nunca pausa, nunca muda valor e nunca ativa nada. Todo dia, ele deve: 1) ler gasto, cliques, impressões e conversões de cada campanha do dia fechado; 2) ler as vendas pagas na minha plataforma de venda, que é a fonte da verdade; 3) se o painel e a plataforma de venda discordarem, avisar a divergência em vez de decidir; 4) comparar o gasto com a minha regra de corte, que vou escrever abaixo; 5) não julgar anúncio com menos de 150 impressões ou R$ 5 de gasto; 6) nunca sugerir corte por CTR em anúncio que já vendeu; 7) me mandar um resumo com cada sugestão, o motivo e o valor atual ao lado do valor novo. Explique cada passo como se eu nunca tivesse programado. Minha regra de corte: [cole aqui].”

    3. Como conferir se a IA acertou

    Teste com os dois casos deste artigo. Primeiro: informe 0 conversões no painel e 1 venda paga de R$ 27,06 na plataforma de venda. O monitor certo aponta a divergência e não manda cortar.

    Segundo: informe um anúncio com CTR de 0,79% e 3 compras, e outro com CTR de 3,17% e zero venda. O certo é proteger o primeiro e julgar só o segundo. Se ele sugerir pausar o que vendeu, reprova.

    4. Custo e tempo

    O Claude Code vem no plano Pro, que custa R$ 110 no mensal ou R$ 92 por mês no anual (R$ 1.100 de uma vez), segundo a página oficial de preços vista do Brasil em 02/10/2026; os preços não incluem impostos aplicáveis. O plano grátis não inclui o Claude Code. O tempo de montagem depende de quantas contas e plataformas de venda entram na leitura; a rotina, depois de pronta, roda uma vez por dia.

    Quando o painel mostra um número e a realidade outro, o caminho é o mesmo de qualquer painel próprio — explicado em como juntar dado de várias fontes num painel só. E o limite do que o agente pode fazer sem perguntar está em como fazer o agente rodar sozinho sem aprovar cada passo.

    E se o alerta disparar e eu não quiser cortar?

    Então a régua estava errada, e isso também é informação. O que não vale é mudar a régua com a campanha rodando e sem registrar o motivo. Antes de declarar um anúncio morto, conferimos quatro causas: gasto sujo, negativas demais bloqueando busca boa, problema na conta e texto da página. Se nenhuma explica, corta.

    Para quem serve esse alerta — e quando não se aplica?

    Se aplica bem:

    • Quem testa anúncio com verba limitada. A regra de corte diz quando parar antes de o prejuízo crescer.
    • Quem vende numa plataforma separada do painel de anúncios. Foi nesse cenário que o painel mostrou 0 conversões e a venda de R$ 27,06 existia.
    • Quem roda várias campanhas ao mesmo tempo. Ler uma por uma, todo dia, é justamente o trabalho que o monitor tira da sua mão.

    Não se aplica tão bem:

    • Verba muito pequena dividida em muitos anúncios. Com seis anúncios dividindo R$ 10 por dia, o terceiro portão levaria cerca de 48 dias. Antes do alerta, é preciso concentrar a verba.
    • Quando você não tem acesso às vendas reais. Sem a plataforma de venda, o alerta fica refém do número do painel, que pode estar errado.
    • Campanha que não busca venda direta. Anúncio para a marca ser lembrada não se mede por gasto contra venda.

    O que a gente faria no seu lugar?

    A gente escreveria a regra de corte antes de ligar o anúncio, com base no quanto se ganha numa venda. Com a campanha rodando, a ansiedade negocia, e sempre parece faltar “só mais um dia”.

    A gente também contaria as vendas na plataforma onde o dinheiro entra, e não no painel. O motivo é o nosso caso: 0 conversões no Google Ads e 1 venda paga de R$ 27,06 na plataforma de venda. Quem faz essa leitura todo dia é o monitor com IA descrito acima — só depois de passar nos dois testes.

    O que a gente não faria: cortar anúncio por CTR. O único que vendeu tinha 0,79%, o pior do conjunto. E não deixaria a regra automática da plataforma pausar sozinha, porque ela decide com o número do painel.

    Em resumo

    Um alerta confiável de “gasta e não vende” é uma rotina diária que conta as vendas na plataforma onde o dinheiro entra, desconta o gasto sujo e compara com uma regra de corte escrita antes do anúncio ir ao ar.

    A máquina lê e avisa; pausar, mudar valor e ativar continuam sendo decisão humana, porque painel com tag quebrada, pausa escondida em quatro níveis e configuração alterada sozinha enganam qualquer regra automática.

    Este artigo faz parte do pilar Operação e processo — como documentar sem virar burocracia.
  • Dá pra rodar automação com IA num computador comum de 8 GB — ou vou precisar de servidor?

    Dá pra rodar automação com IA num computador comum de 8 GB — ou vou precisar de servidor?

    Dá, desde que a IA pesada rode na nuvem e o computador só execute as tarefas. Um PC com Windows 11 e 8 GB de RAM aguenta agendar rotinas, rodar scripts (listas de comandos) e manter sistemas locais abertos. O que precisa ficar ligado 24 horas, como receber mensagem de cliente, vai para um servidor (computador sempre ligado).

    Computador comum ligado por um fio de luz a uma nuvem com um cérebro roxo, trocando pequenos envelopes e engrenagens.
    A parte pesada da IA roda na nuvem; o computador comum só executa as tarefas agendadas.

    Se você já tentou deixar uma automação rodando e o computador ficou lento, ou uma janela preta começou a piscar no meio do trabalho, o problema quase nunca é a IA. É como a tarefa foi agendada e o que mais estava aberto na máquina.

    Quanto de computador a ferramenta de IA pede de verdade?

    Bem menos do que parece. A documentação oficial do Claude Code lista como requisito 4 GB de RAM, processador x64 ou ARM64, Windows 10 1809 ou mais novo e conexão com a internet obrigatória.

    A conexão obrigatória explica o número baixo: o modelo de IA não roda no seu computador. A máquina só roda o programa que conversa com ele e executa os comandos que ele devolve. Num PC de 8 GB, a ferramenta cabe com folga. O aperto vem do resto que fica aberto.

    Quando a tarefa pode ficar no PC e quando precisa de servidor?

    A linha divisória é simples. O que depende de você estar com o PC ligado pode ficar local. O que precisa responder a qualquer hora vai para fora.

    Tipo de tarefaOnde rodaPor quê
    Rotina diária (relatório, conferência, limpeza)Computador localPode esperar o PC ligar
    Vigiar o desempenho da própria máquinaComputador localSó faz sentido com o PC ligado
    Sistema interno que só você usa no diaComputador localAberto quando você trabalha
    Receber mensagem, formulário ou aviso de outro sistemaServidorPrecisa estar no ar às 3 da manhã
    Atendimento automático a clienteServidorNão pode depender do seu PC acordado

    Computador desligado não recebe nada. Se a tarefa é reagir a algo que vem de fora, ela não mora no PC.

    Como agendar uma tarefa para rodar sozinha no Windows?

    O caminho nativo é o Agendador de Tarefas. Segundo a documentação da Microsoft, ele dispara uma tarefa quando um critério é atendido. Pode ser horário fixo, repetição diária ou semanal, login do usuário, o sistema ligando ou o computador ficando ocioso.

    Um ajuste que usamos em toda tarefa recorrente é a opção de iniciar quando disponível. No PowerShell, ela se chama `-StartWhenAvailable`. Pela referência oficial do comando, ela permite que a tarefa rode depois do horário previsto, se o PC estava desligado na hora. Sem isso, rotina perdida é rotina que simplesmente não aconteceu.

    Onde o agendamento engana quem está começando?

    Em três opções com nome enganoso ou valor padrão escondido. Todas estão na mesma referência oficial da Microsoft.

    • `-Hidden` não esconde a janela. Pela documentação, ela só esconde a tarefa da lista do Agendador. A janela preta continua aparecendo.
    • Notebook na bateria. Existe uma opção própria para a tarefa começar mesmo fora da tomada (`-AllowStartIfOnBatteries`). Outra impede que ela pare quando o cabo sai (`-DontStopIfGoingOnBatteries`).
    • Limite de tempo. Sem configurar, o Agendador dá até três dias para a tarefa terminar. Uma rotina travada pode ficar presa esse tempo todo.

    Nenhuma dessas é falha da IA. É configuração do Windows que ninguém avisa antes.

    Por que a janela preta fica piscando na tela a cada execução?

    Porque o Windows cria a janela do console (a tela preta de comandos) antes de o script obedecer à ordem de ficar escondido. Isso aconteceu com uma tarefa nossa que rodava a cada 10 minutos. Mesmo com a opção de janela oculta no PowerShell, o console piscava na tela em toda execução e interrompia o trabalho.

    A reclamação foi direta, e o risco era real: automação que atrapalha vira automação desligada. A correção não foi mexer no script, foi mudar quem o chama.

    Como rodar a automação escondida, sem janela nenhuma?

    A tarefa agendada deixou de chamar o PowerShell diretamente. Passou a chamar um lançador pequeno em VBScript, executado pelo `wscript.exe`. Esse lançador abre o script com estilo de janela 0, que significa invisível desde o início.

    • Antes: Agendador → PowerShell com opção oculta → janela pisca
    • Depois: Agendador → `wscript.exe` → lançador `.vbs` → PowerShell sem janela

    Virou regra da casa: nenhuma automação recorrente é registrada no Agendador apontando direto para o PowerShell. O lançador oculto entra em toda tarefa nova, não só na que deu problema.

    Quanto de memória sobra de verdade num PC de 8 GB?

    Menos do que você imagina, e quase nunca por causa da IA. Medimos a máquina onde essas automações rodam, com 8 GB de RAM física. Havia só 606 MB livres. Os maiores consumidores:

    ProcessoMemória
    Navegador Chrome (22 processos)cerca de 2,1 GB
    Claude Codecerca de 1,1 GB
    Componente de páginas web embutidas do Windows722 MB

    O gargalo era RAM física apertada. E o maior ganho possível não era mexer na automação: era fechar abas ociosas do navegador.

    Como monitorar o PC para ele não travar?

    Montamos um vigia próprio, com Claude Code, que roda pelo mesmo Agendador.

    A primeira lição dele: a porcentagem de memória em uso engana. Ficar entre 85% e 92% costuma ser normal, porque o Windows usa memória como cache (uma reserva rápida que ele libera quando precisa). O que importa é a RAM livre e a memória confirmada (o total que os programas já pediram ao Windows).

    Os limites que o vigia usa:

    • alerta abaixo de 800 MB de RAM livre
    • alerta com memória confirmada acima de 80%
    • só considera fechar app que use mais de 150 MB
    • só age se você estiver parado há 15 minutos

    Qual o risco se o monitoramento automático fechar algo importante?

    Um vigia que fecha programas sozinho só é seguro se for conservador. O nosso segue uma escada, do mais suave ao mais forte. Primeiro coloca o app em Modo de Eficiência, que é reversível. Depois pede para fechar normalmente, o que dá chance de salvar. Forçar o fechamento é último recurso.

    Por cima disso existem travas que não se desligam. Uma lista fixa de processos essenciais do Windows nunca é tocada. O app que está na tela agora também não, nem o que foi usado nos últimos minutos. Há ainda uma lista protegida escolhida pelo usuário. Na dúvida, ele só registra a sugestão e não fecha nada.

    Dá pra rodar vários sistemas locais ao mesmo tempo?

    Dá, com uma regra: cada sistema na sua porta fixa (o número de “endereço” que cada app usa dentro do PC), anotada numa lista. Temos quatro apps locais convivendo na mesma máquina, cada um em uma porta.

    O que deu errado foi um deles deixar registrado no navegador um componente que guarda cache. Esse componente passou a servir o app antigo por cima de qualquer outro que subisse na mesma porta.

    O sintoma foi uma tela branca com erro num arquivo que nem existia no projeto. A saída foi usar outra porta. E configurar o app para falhar com erro claro se a porta estiver ocupada, em vez de pular para outra em silêncio.

    Para quem serve: em quais casos isso se aplica bem — e quando não?

    Rodar automação com IA num PC de 8 GB se aplica bem nos seguintes casos:

    • Rotinas que podem esperar o PC ligar, como relatório diário, conferência ou limpeza de arquivos.
    • Quem trabalha na mesma máquina todo dia e pode deixar o Agendador cuidar do horário.
    • Sistemas internos que só você usa, abertos enquanto você trabalha.

    Não se aplica bem quando:

    • A tarefa precisa responder cliente a qualquer hora. Computador desligado não recebe nada; isso vai para servidor.
    • A máquina vive com dezenas de abas abertas e não dá para fechar nenhuma. No nosso caso, o Chrome sozinho usava cerca de 2,1 GB.
    • O notebook passa o dia fora da tomada e ninguém ajustou as opções de bateria da tarefa.

    Como resolver isso com IA, passo a passo?

    1. O que construir

    Uma skill no Claude (um conjunto de instruções salvo, que a IA segue sempre do mesmo jeito) que agenda rotinas do jeito certo no Windows. Ela registra cada tarefa no Agendador apontando para o lançador oculto, nunca direto para o PowerShell, e liga o `-StartWhenAvailable`. Junto, ela monta o vigia de memória com os limites deste artigo, que só avisa e sugere — sem fechar nada sozinho.

    2. O pedido pronto para copiar

    O pedido que recomendamos colar no Claude Code:

    “Crie uma skill para agendar rotinas no meu Windows 11 com 8 GB de RAM. Regras: 1) toda tarefa recorrente chama o wscript.exe com um lançador .vbs de janela invisível, nunca o PowerShell direto; 2) toda tarefa usa -StartWhenAvailable e um limite de tempo curto, não os três dias padrão; 3) se for notebook, pergunte antes sobre as opções de bateria; 4) crie também um vigia de memória que avisa abaixo de 800 MB de RAM livre ou com memória confirmada acima de 80%, e que só registra sugestões, sem fechar programa nenhum; 5) antes de registrar qualquer tarefa, me mostre o que vai ser criado e espere meu ok. Explique cada passo como se eu nunca tivesse programado.”

    3. Como conferir se a IA acertou

    Use a medição deste artigo como teste. Informe ao vigia uma máquina com 606 MB livres: o certo é disparar o alerta, porque está abaixo de 800 MB. Depois informe 88% de memória em uso com bastante RAM livre: o certo é não alertar, porque entre 85% e 92% costuma ser normal. Por fim, rode a tarefa agendada: se a janela preta piscar uma vez, a skill errou.

    4. Custo e tempo

    O Claude Code vem no plano Pro, que custa R$ 110 no mensal ou R$ 92 por mês no anual (R$ 1.100 de uma vez), segundo a página oficial de preços vista do Brasil em 02/10/2026; os preços não incluem impostos aplicáveis. O plano grátis não inclui o Claude Code. Não precisa comprar computador: o requisito oficial é 4 GB de RAM. O lançador oculto e o `-StartWhenAvailable` custam minutos, como dito abaixo; o vigia completo depende de quantas travas de proteção você quiser.

    O que a gente faria no seu lugar?

    A gente não compraria computador novo antes de medir. Na nossa máquina de 8 GB, o Claude Code usava cerca de 1,1 GB. O navegador, cerca de 2,1 GB. O problema estava nas abas, não na IA.

    A gente também usaria o lançador oculto desde a primeira tarefa. E ligaria o `-StartWhenAvailable` em toda rotina recorrente. As duas coisas custam minutos e evitam a automação desligada por irritação. Deixaríamos isso por conta da skill descrita acima, para nenhuma tarefa nova nascer sem as duas.

    O que a gente não faria: colocar atendimento a cliente no PC do escritório. Nem deixar um vigia fechar programa sem lista de proteção e sem esperar 15 minutos parado.

    O que você consegue fazer depois de ajustar isso?

    Deixar rotinas agendadas rodando enquanto trabalha, sem janela piscando e sem o computador arrastar. E saber exatamente quais delas precisam sair do PC para um servidor.

    O primeiro passo prático costuma ser instalar a ferramenta e rodar a primeira tarefa. Depois, fazer o agente rodar sem pedir aprovação a cada passo. O custo do servidor, quando ele entra, aparece no caso de um CRM (o sistema que guarda o histórico de cada cliente) construído sem contratar dev.

    Em resumo

    Um computador comum de 8 GB roda automação com IA porque o modelo trabalha na nuvem e a máquina só executa as tarefas. Elas são agendadas pelo Agendador de Tarefas do Windows, com um lançador oculto para não piscar janela.

    O que precisa responder 24 horas vai para servidor. E o que trava o PC quase sempre é o navegador, não a automação.

    Este artigo faz parte do pilar Eu não sou programador — dá pra construir com IA mesmo assim?.

  • Como saber se o sistema que a IA construiu é seguro antes de colocar no ar?

    Como saber se o sistema que a IA construiu é seguro antes de colocar no ar?

    Você só sabe fazendo uma auditoria antes de publicar, que pode ser somente leitura: olhar código, configuração e dependências sem mexer em nada. O roteiro mais usado é o chamado OWASP Top 10, a lista aberta dos dez riscos mais comuns em aplicações web. Em sistema feito com IA, comece por chave no código e rota sem login.

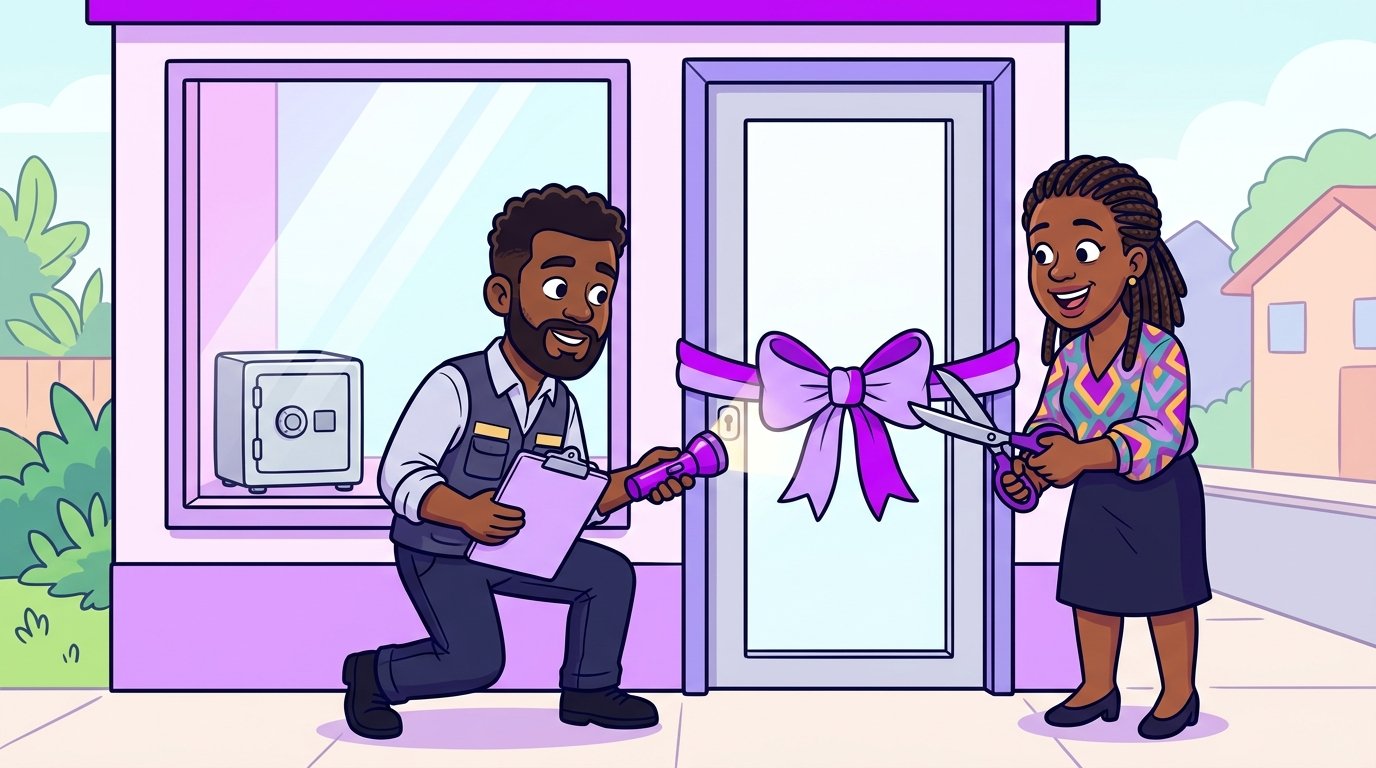
    Inspetor com prancheta e lanterna roxa conferindo fechaduras de uma casinha nova antes de a dona cortar o laço da inauguração.
    Antes de inaugurar, uma vistoria só olhando: portas, janelas e cofre conferidos sem mexer em nada.

    O sistema funciona na demonstração, o cliente consegue se cadastrar, o painel abre bonito. É justamente aí que mora o risco. A IA que escreveu o código foi otimizada para fazer funcionar, não para resistir a quem quer entrar sem convite.

    O que é o OWASP Top 10 e por que ele serve de checklist?

    O OWASP é uma fundação sem fins lucrativos que mantém, de forma aberta, a lista dos dez riscos mais frequentes em aplicações web. A edição atual é a OWASP Top 10:2025, e ela serve de checklist porque cada categoria vira uma pergunta que dá para responder olhando o sistema.

    Não é norma nem certificação. É um mapa de onde os problemas costumam aparecer, montado a partir de dados de testes reais. Para quem não é da área, a utilidade prática é outra: ele impede que a revisão dependa da memória de quem está olhando.

    Quais são as dez categorias da edição 2025?

    A lista oficial, na ordem em que a própria fundação publica, com a pergunta que cada item vira na hora de revisar:

    CódigoCategoriaA pergunta na revisão
    A01Controle de acesso quebradoUm usuário consegue ver ou mudar o que é de outro?
    A02Configuração de segurança erradaFicou algo no modo “teste” ou aberto por padrão?
    A03Falhas na cadeia de suprimentos de softwareAs bibliotecas usadas têm falha conhecida?
    A04Falhas de criptografiaSenha e dado sensível estão protegidos?
    A05InjeçãoO que o usuário digita pode virar comando?
    A06Design inseguroO fluxo foi pensado para quem tenta burlar?
    A07Falhas de autenticaçãoLogin e sessão resistem a abuso?
    A08Falhas de integridade de software ou dadosDá para confiar no que chega de fora?
    A09Falhas de registro e alertaSe alguém invadir, você fica sabendo?
    A10Tratamento incorreto de condições excepcionaisQuando algo dá erro, o sistema falha fechado?

    O que costuma escapar num sistema construído com IA?

    Os furos de sistema gerado por IA são previsíveis, porque o gerador sempre corta o mesmo caminho para o código rodar logo. No roteiro de auditoria que usamos, eles viraram uma lista própria, conferida antes de todo o resto:

    • Chave de API (a senha que abre a porta de outro sistema) escrita direto no código ou exposta na parte que roda no navegador do visitante
    • Rota sem autenticação: o endereço da API responde a quem não fez login
    • Consulta que não confere o dono: basta trocar o número do cadastro na URL para ver o de outra pessoa
    • Banco com regra de acesso desligada ou em modo de teste, como acontece em plataformas tipo Supabase e Firebase
    • Chave de administrador no lado do cliente, que ignora qualquer regra de acesso
    • Validação só na tela, sem conferência no servidor (o computador que guarda os dados e responde aos pedidos)

    Quase todos caem no A01 da lista. Não por acaso, a página oficial dessa categoria registra que ela apareceu em 100% das aplicações testadas.

    Por que a auditoria precisa ser somente leitura?

    Porque o sistema que você quer proteger às vezes já está no ar, com dado de cliente de verdade. Uma revisão que testa ataque contra produção pode derrubar serviço, criar registro falso ou apagar informação — e aí o estrago veio da própria checagem.

    A regra que seguimos separa duas coisas. Ler código, configuração, histórico de versões e lista de dependências é sempre seguro. Isso pode ser feito direto. Qualquer teste ativo contra produção, como enviar dados maliciosos a um formulário ou criar conta de teste, só acontece depois de montado, explicado e aprovado por uma pessoa.

    Como resolver isso com IA, passo a passo?

    1. O que construir. Uma skill de auditoria no Claude Code (uma skill é um conjunto de instruções salvas que a IA segue sempre do mesmo jeito), somente leitura, que confere o sistema contra o OWASP Top 10 e os seis furos típicos de código feito por IA. Ela entrega um relatório com cada achado, a prova (arquivo, linha ou configuração), a gravidade e a correção sugerida. É o desenho da auditoria que usamos.

    A auditoria que rodamos foi construída com o Claude Code e vive como um roteiro fixo, não como pergunta solta a um chat. Ela olha o sistema em 3 camadas (código, dados e privacidade, servidor), percorre 8 fases e se apoia em 10 guias de referência, um deles só para os furos típicos de sistema feito com IA.

    PeçaO que faz
    Varredura de segredosProcura chave e senha no código e no histórico de versões
    Auditoria de dependênciasLista biblioteca com falha conhecida
    Checagem de cabeçalhosOlha de fora proteções do navegador, conexão segura e origens permitidas
    Consulta de regras do bancoLista tabelas sem regra de acesso por linha, rodada pelo próprio dono

    São 4 scripts (pequenos programas que fazem a checagem sozinhos), todos de leitura. Cada achado sai com severidade, explicação em português simples e correção sugerida, e o conjunto fecha com uma nota de A a F.

    2. O pedido pronto para copiar. O pedido que recomendamos colar no Claude Code, aberto na pasta do sistema:

    “Crie uma skill chamada ‘auditar antes de publicar’, somente leitura: ela não pode alterar nenhum arquivo, nem enviar nada para o sistema no ar. Ela deve conferir o projeto contra as dez categorias do OWASP Top 10:2025 e, antes de tudo, contra estes furos: chave de API no código ou no histórico de versões, rota que responde sem login, consulta que não confere o dono do cadastro, banco com regra de acesso desligada, chave de administrador no lado do navegador e validação feita só na tela. Para cada item, mostre a prova: arquivo, linha ou configuração. Nunca mostre uma chave por inteiro; mascare. Termine com uma nota de A a F e um plano de correção em ordem de gravidade, sem corrigir nada sozinha. Explique tudo em português simples.”

    Como conferir se a auditoria de IA acertou?

    3. O teste da chave plantada. Faça uma cópia de teste do sistema e plante dois furos da lista deste artigo. Primeiro, escreva uma chave falsa no código, salve no histórico e depois apague a linha. Segundo, deixe uma rota respondendo sem login. A skill certa acha a chave mesmo apagada, porque ela continua no histórico, e mostra a chave mascarada. E classifica a rota aberta no A01, a categoria que a OWASP registrou em 100% das aplicações testadas. Se ela responder só “está seguro”, está reprovada.

    Quanto custa e quanto tempo leva para montar a auditoria?

    4. Custo e tempo. A skill roda no Claude Code. A página oficial de preços do Claude, vista do Brasil em 02/10/2026, mostra o plano Pro a R$ 110 no mensal ou R$ 92 por mês no anual (R$ 1.100 de uma vez), com o Claude Code incluído. O plano Free é R$ 0 e não inclui o Claude Code. Os preços não incluem impostos aplicáveis. A lista do OWASP é aberta e não custa nada. O tempo para montar e rodar depende do tamanho do sistema; não medimos esse número à parte.

    E quando a auditoria encontra um problema?

    Primeiro, nada é corrigido automaticamente. O relatório lista os achados e um plano em ordem de gravidade; a correção acontece com aprovação, uma de cada vez, começando pelas críticas.

    Segundo, segredo encontrado nunca aparece por inteiro no relatório: ele sai mascarado, com a recomendação de trocar a chave. Apagar a linha do código não basta, porque ela continua no histórico. É o que o guia de gestão de segredos da OWASP orienta: chave exposta deve ser revogada imediatamente e substituída por uma nova.

    Quem pode fazer essa revisão se eu não sou técnico?

    Você mesmo pode fazer a primeira passada, desde que você trate a IA como auditora e não como quem aprova o próprio trabalho. A diferença está em pedir a revisão contra uma lista fechada, como as dez categorias acima e os seis furos típicos, e exigir evidência para cada item: o arquivo, a linha, a configuração.

    “Está seguro?” é uma pergunta que qualquer ferramenta responde com um sim confiante. “Mostre onde cada rota confere o login” só tem resposta se o trabalho foi feito. É o mesmo princípio de conferir o que a automação diz ter salvo, que contamos em o que fazer quando a automação que a IA construiu quebra.

    Quando essa revisão deve acontecer?

    Em dois momentos, e usamos os dois modos. O modo construir entra enquanto o sistema nasce: a regra da casa, desde julho de 2026, é que todo app, API ou página siga o OWASP Top 10 como padrão, com chave fora do código e autorização checada no servidor. O modo auditar entra antes de publicar, com nota de 0 a 10 por categoria.

    Tratar segurança como etapa final, depois que “ficou pronto”, é o que faz o furo ir junto para o ar. Custa menos prevenir do que descobrir pelo cliente.

    O que muda depois de ter esse checklist

    Você deixa de publicar com base no “funcionou na tela” e passa a publicar com uma lista conferida item por item, com prova. A segurança do sistema construído é um assunto; a do dado que você manda para a IA é outro, e está em é seguro usar IA com os dados dos meus clientes.

    Em quais casos essa auditoria se aplica bem — e quando não?

    Ela se aplica bem nos seguintes casos:

    • Sistema com login, em que cada pessoa só pode ver o que é dela. É o terreno do A01.
    • Sistema que guarda dado de cliente, como cadastro, pedido ou contato.
    • Sistema que conversa com outros serviços por chave, como pagamento ou envio de mensagens.
    • Sistema que já está no ar e vai ganhar uma função nova.

    Ela pede menos esforço num protótipo que só roda no seu computador, sem dado real e sem endereço na internet. Ali, o modo construir basta por enquanto.

    Mas o protótipo não pula a auditoria. Ela só muda de hora: entra no dia em que ele for para o ar.

    O que a gente faria no seu lugar?

    Nós não publicaríamos nenhum sistema com login ou dado de cliente sem conferir primeiro o controle de acesso. O motivo está no próprio artigo. A categoria A01 apareceu em 100% das aplicações testadas, e quase todos os furos típicos de código feito por IA caem nela.

    Faríamos a auditoria somente leitura antes de tudo, com a skill “auditar antes de publicar” do passo a passo acima e o teste da chave plantada feito uma vez para confiar nela. Qualquer teste ativo ficaria para depois, com aprovação de uma pessoa.

    O que não faríamos: perguntar “está seguro?” para a mesma IA que escreveu o código e aceitar o sim. Também não deixaríamos a correção rodar sozinha. E não apagaríamos uma chave exposta sem trocá-la por uma nova.

    Em resumo

    Sistema feito com IA fica seguro para publicar quando passa por uma auditoria somente leitura, guiada pelas dez categorias do OWASP Top 10 e pelos furos típicos de código gerado, como chave no código e rota sem login. A revisão não corrige nada sozinha: ela aponta, dá nota e deixa a correção para depois de aprovada, começando pelo que é crítico.

    Este artigo faz parte do pilar Eu não sou programador — dá pra construir com IA mesmo assim?.

  • Como saber de onde veio cada cliente que entrou no meu cadastro — e por que o mesmo cliente pode aparecer duas vezes?

    Como saber de onde veio cada cliente que entrou no meu cadastro — e por que o mesmo cliente pode aparecer duas vezes?

    Para saber de onde veio cada cliente, cada porta de entrada precisa carimbar o contato na chegada: o formulário aplica uma etiqueta, o WhatsApp aplica outra e o link da campanha leva parâmetros UTM (etiquetas escritas no próprio link). Etiqueta posta depois, à mão, se perde. E o telefone deve ser comparado sem depender do formato.

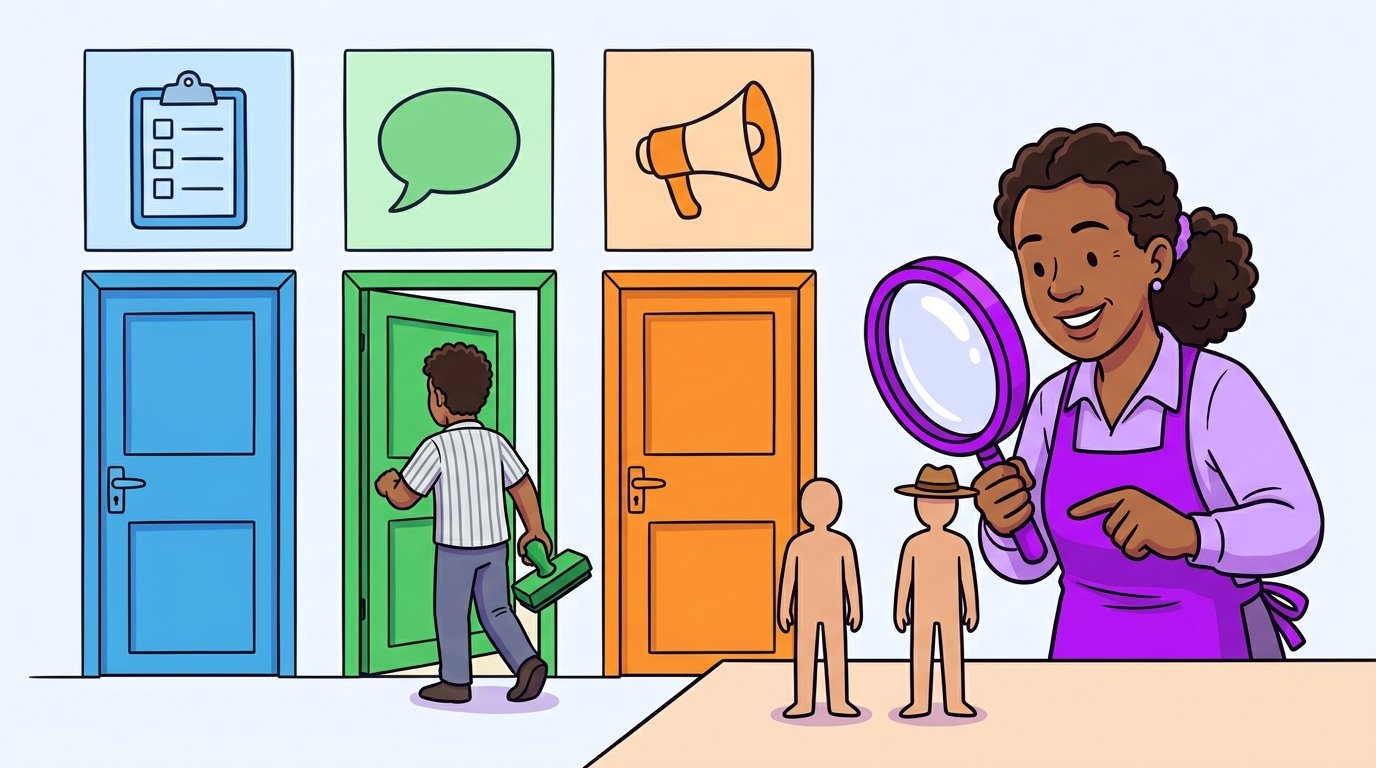
    Três portas carimbando cores nas mãos de quem entra; lá dentro, o dono percebe com uma lupa roxa que duas pessoas são a mesma.
    Cada porta de entrada carimba o cliente na chegada. E é preciso conferir quando a mesma pessoa aparece duas vezes.

    Faça já (2 minutos), sem mexer em nada: preencha o seu próprio formulário de contato com um telefone que nunca entrou no cadastro. Depois abra a ficha que chegou.

    Ela diz por onde a pessoa entrou? Se não diz, o seu cadastro tem uma porta sem carimbo — exatamente o que achamos no nosso: só 2 de 7 contatos tinham alguma marca de origem.

    Quando for subir a próxima campanha, repita esse teste antes de pagar o primeiro clique.

    Quem abre o cadastro e vê uma lista de nomes sem nenhuma pista de origem não consegue responder a pergunta mais básica do negócio: qual canal está trazendo gente. Foi o que aconteceu num CRM (o sistema que guarda a ficha de cada cliente) próprio que mantemos em produção. E o conserto mostrou que a origem se perde em lugares que ninguém olha.

    Por que o contato entra no cadastro sem dizer de onde veio?

    Porque, na maioria dos sistemas, etiquetar a entrada é configuração, não comportamento padrão. No nosso caso, o CRM só etiquetava automaticamente quem comprava: a confirmação da plataforma de pagamento aplicava as etiquetas de compra, e isso estava escrito direto no código.

    A etiqueta de entrada dependia de um campo no painel de cada formulário, chamado “tag inicial”. Seis formulários estavam com esse campo em branco. O sétimo apontava para uma etiqueta que tinha sido apagada — e o sistema aceitava isso sem reclamar. Na tela, só dois de sete contatos tinham alguma marca de origem.

    Que etiqueta cada porta de entrada deve aplicar?

    A regra que adotamos é simples: uma etiqueta por porta, aplicada pelo próprio sistema, na hora da entrada. Nada de etiquetar depois, olhando a lista.

    Porta de entradaQuem aplica a etiquetaO que registra
    Formulário de capturao próprio formulário (campo de etiqueta inicial)qual formulário, em qual página
    Conversa no WhatsAppuma automação “mensagem recebida → adicionar etiqueta”que o contato chegou pelo WhatsApp
    Compraa confirmação da plataforma de pagamentoo que comprou
    Campanha pagaparâmetros UTM no linkfonte, meio e nome da campanha

    O nome da etiqueta deve dizer a porta, não o humor do dia: “formulário-página-de-vendas” é útil daqui a seis meses; “lead quente” não é.

    Como etiquetar automaticamente quem chega pelo WhatsApp?

    Com uma automação disparada a cada mensagem recebida, cuja única ação é adicionar a etiqueta de WhatsApp. No nosso CRM, ela foi criada sem mexer em código: não envia mensagem, não move o contato no funil e não mexe em quem já estava no cadastro antes de ela existir.

    O detalhe que a torna segura é ser idempotente (fazer a mesma coisa duas vezes dá o mesmo resultado de fazer uma): ela dispara em toda mensagem, mas antes de gravar confere se o contato já tem aquela etiqueta. Mil mensagens do mesmo cliente geram uma etiqueta só. A própria etiqueta foi criada automaticamente na primeira execução.

    O que os parâmetros UTM resolvem que a etiqueta não resolve?

    A etiqueta diz por qual porta o contato entrou. O UTM diz qual anúncio ou link o levou até aquela porta. Se duas campanhas mandam para o mesmo formulário, a etiqueta das duas é igual; só o UTM separa uma da outra.

    A documentação oficial do Google Analytics sobre URLs personalizados define três parâmetros que devem estar sempre presentes: `utm_source` (de onde), `utm_medium` (que tipo de mídia) e `utm_campaign` (qual campanha). Ela também avisa que os valores diferenciam maiúsculas de minúsculas: “google” e “Google” viram duas fontes diferentes no relatório. Padronizar tudo em minúsculas evita esse racha.

    Para o WhatsApp, onde não existe formulário para receber o UTM, o recurso de conversa em um clique permite um link com mensagem pré-preenchida. Um texto diferente por campanha já indica a origem na primeira mensagem.

    Por que o mesmo cliente aparece duas vezes no cadastro?

    Porque o sistema compara telefones como texto, caractere por caractere. No nosso CRM, encontramos em produção a mesma pessoa cadastrada duas vezes: uma entrada vinda do WhatsApp, com 10 dígitos e sem etiqueta nenhuma; outra vinda do formulário, com 11 dígitos e as etiquetas de compra.

    A diferença era só o 9 da frente do celular. O WhatsApp entregou o número sem ele; no formulário, a pessoa digitou com ele. Desde 2016 todo celular brasileiro tem nove dígitos, com o 9 acrescentado antes do número, como registrou a Agência Brasil na conclusão da mudança — mas o número continua chegando nos dois formatos, dependendo da porta.

    Por que o telefone duplicado estraga a origem do cliente?

    Porque a origem fica partida em duas fichas e nenhuma delas conta a história inteira. A ficha do WhatsApp diz que a pessoa chegou por lá, mas não sabe que ela comprou. A ficha do formulário sabe da compra, mas não sabe da conversa. Qualquer relatório de “qual canal vende” sai errado, e automações de recuperação podem mirar em quem já é cliente.

    O agravante: o código do nosso CRM já tinha uma função pronta para comparar telefones ignorando formato. Ela só não era usada na hora de verificar duplicidade.

    Por isso esse furo não tem contorno pelo painel: o conserto é uma alteração de código. No nosso caso, ele ainda está na fila — a mudança está entendida, mas depende de acesso ao servidor (o computador onde o sistema roda de verdade), e esse acesso não estava liberado. Enquanto isso, a ficha duplicada continua lá, e nós sabemos exatamente qual é.

    E quando o mesmo cliente entra de novo por outra campanha?

    Aqui mora uma pegadinha que parece defeito e não é. Quando um formulário recebe um telefone que já existe, o sistema não cria contato novo, não sobrescreve nome, e-mail nem origem, mantém a data de cadastro original e não abre card novo no funil. Mesmo assim, responde “enviado com sucesso”.

    Na prática, o cadastro guarda a primeira origem. É uma escolha defensável — mas precisa ser conhecida. Quem testa o formulário com o próprio telefone repetido acha que “o lead não chegou”, quando ele chegou e foi fundido ao contato antigo. Se a segunda campanha importa, ela precisa virar uma etiqueta a mais, nunca uma troca da primeira.

    Como testar se a etiqueta de entrada está funcionando?

    Com um teste controlado, não com a conferência visual da lista. O que fizemos:

    1. escolher um formulário sem funil ligado, para o teste não disparar nenhuma sequência de mensagens;
    2. enviar com um telefone nunca usado antes — com telefone repetido, a regra de fusão esconde o resultado;
    3. conferir o contador da etiqueta: foi de 0 para 1, e o contato apareceu com a etiqueta colada;
    4. apagar o contato de teste e confirmar que o contador voltou a 0.

    Logo depois da correção, as etiquetas novas ficaram zeradas por um tempo. Isso era esperado — nenhum contato novo tinha entrado ainda — e não era defeito. Contador zerado só é problema depois que alguém entrou.

    Qual problema continua aberto mesmo com tudo etiquetado?

    O contato que chega pelo WhatsApp não dispara o evento (o aviso interno que o sistema dá quando algo acontece) de “contato criado” no nosso CRM. A etiqueta resolve a origem. Mas uma régua de recuperação, a sequência automática de mensagens para quem não comprou, começa nesse evento e não enxerga quem veio pela conversa.

    Colocar essas pessoas na régua exigiria disparar mensagens de verdade — decisão de gente, nunca da automação. Mais sobre esse tipo de falha silenciosa está em o que fazer quando a automação quebra e a tela dizia que estava tudo certo.

    O que se ganha com a regra aplicada é concreto: abrir o cadastro e filtrar por porta de entrada, e juntar essa origem com os números de venda num lugar só. O custo e os tropeços de manter esse CRM estão em quanto custa construir um CRM sem contratar dev.

    Quando conferir se a origem está sendo gravada?

    Em três momentos, todos tirados do que deu errado no nosso caso:

    • Ao criar um formulário novo. Foi assim que seis formulários ficaram com a etiqueta inicial em branco. O campo é opcional, e ninguém é obrigado a preencher.
    • Ao apagar ou renomear uma etiqueta. O sétimo formulário apontava para uma etiqueta apagada, e o sistema não reclamou. Quem apaga etiqueta precisa conferir quem usava.
    • Ao subir uma campanha nova. Antes de pagar o primeiro clique, faça o teste controlado descrito acima com um telefone nunca usado.

    Fora desses momentos, basta olhar o contador de cada etiqueta de vez em quando. Contador parado enquanto entra gente é sinal de porta sem carimbo.

    Isso faz diferença no meu negócio — ou só em quem tem várias portas de entrada?

    Se aplica bem:

    • Negócio com mais de uma porta de entrada. Formulário, WhatsApp e anúncio ao mesmo tempo. Sem carimbo, não dá pra comparar um canal com o outro.
    • Quem paga anúncio. Só o UTM separa duas campanhas que mandam para o mesmo formulário.
    • Quem usa mensagem automática de recuperação. Com ficha duplicada, a mensagem pode mirar em quem já comprou.

    Não se aplica tão bem:

    • Quando todo cliente chega pela mesma porta. Se só existe o WhatsApp, a etiqueta diria sempre a mesma coisa. Aí o que importa é o texto de campanha no link de conversa.
    • Quando o cliente chega por indicação, sem link. Nenhum carimbo automático pega o boca a boca. Nesse caso, a origem só aparece se alguém perguntar “como nos conheceu?” e anotar.

    Que skill montar para a IA vigiar a origem por você?

    1. O que construir. Uma skill de auditoria de origem no Claude Code (uma skill é um conjunto de instruções salvas que a IA segue sempre do mesmo jeito). Ela faz duas coisas que, no nosso caso, ninguém tinha feito à mão. Primeiro, lista cada formulário e diz qual está sem etiqueta de entrada ou apontando para etiqueta apagada. Segundo, procura fichas duplicadas comparando só os dígitos do telefone, com e sem o 9 da frente. Ela mostra o que achou e não junta nem apaga ficha sozinha.

    2. O pedido pronto para copiar. O pedido que recomendamos colar no Claude Code, dentro da pasta do seu CRM:

    “Crie uma skill chamada ‘auditar origem dos clientes’. Ela deve: 1) listar todos os formulários de captura e marcar os que estão com a etiqueta inicial em branco ou apontando para uma etiqueta que não existe mais; 2) procurar contatos duplicados comparando só os números do telefone, tratando como a mesma pessoa um celular com e sem o 9 da frente, e me mostrar os pares lado a lado com as etiquetas de cada ficha; 3) conferir se o código já tem uma função que compara telefones ignorando o formato e me dizer se ela está sendo usada na checagem de duplicidade; 4) não juntar, não apagar e não disparar mensagem nenhuma sem meu ok. Me mostre o resultado numa tabela e explique em português simples.”

    Como conferir se a auditoria acertou?

    3. O teste dos sete formulários. Use o caso deste artigo como gabarito. Num cadastro como o nosso, a resposta certa é: seis formulários com a etiqueta inicial em branco e um apontando para etiqueta apagada. Cadastre de teste a mesma pessoa duas vezes, uma com 10 dígitos e outra com 11, como aconteceu aqui. A skill tem que mostrar as duas fichas como um par só. Depois da correção, repita o teste controlado da seção acima: o contador da etiqueta tem que ir de 0 para 1 e voltar a 0 ao apagar o contato de teste.

    E se o meu CRM for um sistema pronto, e não próprio?

    A parte da etiqueta por porta vale igual: na maioria dos sistemas, etiqueta de entrada é configuração de formulário e de automação, e dá para conferir pelo painel com o teste de 2 minutos.

    A parte do telefone duplicado depende de como o fornecedor compara números. Pergunte ao suporte, com o exemplo deste artigo: “o mesmo celular com e sem o 9 da frente vira um contato só ou dois?”. Se a resposta for “dois”, exporte a lista de contatos e peça para a IA achar os pares comparando só os dígitos — sem apagar nada sozinha.

    Quanto custa ter essa auditoria rodando?

    4. Custo e tempo. O teste de 2 minutos do começo custa zero e não precisa de ferramenta nenhuma. A auditoria automática precisa do Claude Code, que vem a partir do plano Pro — R$ 110 no mensal ou R$ 92 por mês no anual, segundo a página oficial de preços conferida do Brasil em 02/10/2026 (sem impostos). Quanto tempo leva para montar, nós não medimos à parte; o que temos medido é o que o diagnóstico encontrou: 6 formulários com a etiqueta de entrada em branco e 1 apontando para uma etiqueta apagada.

    Se o cadastro fosse começar hoje, por onde a gente começaria?

    A gente consertaria a comparação de telefone antes de qualquer etiqueta. O motivo está no nosso próprio cadastro: a mesma pessoa em duas fichas, uma com 10 e outra com 11 dígitos. Etiqueta bem aplicada numa ficha partida continua contando meia história.

    Depois, a gente poria uma etiqueta por porta, aplicada pelo sistema na hora da entrada. Nos sete formulários, só dois contatos tinham marca de origem. Isso mostra que depender de alguém lembrar não funciona. Por isso a gente deixaria a skill “auditar origem dos clientes” rodar a cada formulário novo e a cada campanha nova, nos três momentos listados acima.

    O que a gente não faria: etiquetar à mão olhando a lista, nem trocar a primeira origem pela segunda campanha. E não jogaria contatos antigos numa sequência de mensagens só para completar a régua. Disparar mensagem de verdade é decisão de gente.

    Saber de onde veio cada cliente exige que cada porta de entrada — formulário, WhatsApp, compra e link de campanha com UTM — carimbe o contato sozinha, no momento em que ele chega. E nenhuma etiqueta sobrevive a um cadastro que trata o mesmo celular, com e sem o 9 da frente, como duas pessoas diferentes.

    Como este artigo foi feito: o caso é do CRM que mantemos em produção. O diagnóstico das etiquetas e o teste controlado foram feitos por nós em 28 e 29/07/2026; a automação de etiqueta do WhatsApp está ativa desde então; o conserto da comparação de telefone segue aberto. A IA ajudou a organizar o texto; os números e os testes são nossos.

    Este artigo faz parte do pilar Do Excel ao sistema próprio — quando a planilha para de dar conta.

  • Como reativar clientes antigos pelo WhatsApp sem ter o número bloqueado — e por que mandar devagar vale mais do que mandar tudo?

    Como reativar clientes antigos pelo WhatsApp sem ter o número bloqueado — e por que mandar devagar vale mais do que mandar tudo?

    Dá para reativar uma base antiga pelo WhatsApp com baixo risco de bloqueio se três coisas andarem juntas: falar só com quem deu o número e aceitou contato, mandar devagar em lotes pequenos e parar quando alguém pedir para sair. E pelo caminho que os termos do WhatsApp permitem: a plataforma oficial.

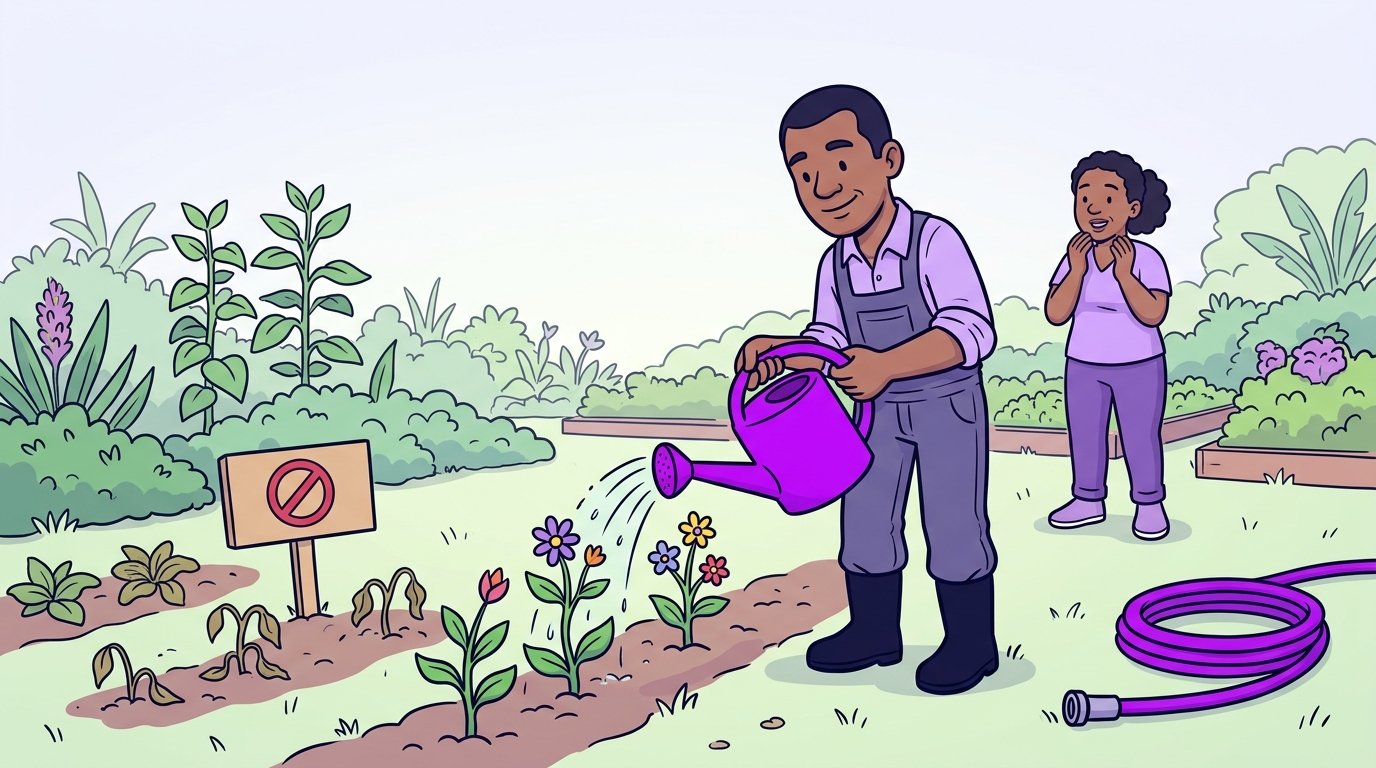
    Jardineiro regando plantinhas uma a uma com um regador roxo, com uma mangueira de alta pressão desligada ao lado.
    Reativar clientes é regar devagar, um por um, e só quem quer receber. A mangueira de pressão afoga a horta.

    Se você tem uma lista de contatos parada há meses e pensa em “mandar pra todo mundo de uma vez”, este é o texto que evita perder o número no primeiro dia.

    Uma nota de vocabulário antes de começar. Quando falarmos em API (a porta que um sistema abre para outro conversar com ele), é a porta oficial que a Meta abre para empresas usarem o WhatsApp.

    O que a política do WhatsApp permite, na letra?

    A Política de Mensagens do WhatsApp Business exige duas condições para contatar alguém. A pessoa precisa ter passado o número para você. E precisa ter dado permissão para receber mensagens (o chamado *opt-in*). A mesma política manda respeitar qualquer pedido para deixar de receber comunicação, feito dentro ou fora do WhatsApp.

    E avisa o mecanismo do bloqueio: usuários podem bloquear ou denunciar a empresa, e os sistemas do WhatsApp podem limitar quantas mensagens ela envia com base nesse retorno. Ou seja, o que derruba o número não é só o volume. É gente dizendo “não pedi isso”.

    Qual a diferença entre API oficial e integração não oficial?

    Circulam no mercado dois caminhos, e só um deles está dentro das regras:

    API oficial (WhatsApp Business Platform)Integração não oficial
    Como conectaPela plataforma da Meta, com número aprovadoConecta o número como se fosse um WhatsApp Web
    Mensagem para base antigaSó por modelo aprovado, o template (texto fixo pré-aprovado)Texto livre
    Custo por mensagemModelo de marketing é cobradoSem cobrança por mensagem
    Limite de envioDefinido pela Meta, por faixaNenhum oficial — você cria o seu
    Risco principalQueda de qualidade e limite reduzidoBanimento do número

    Na oficial, fora da janela de 24 horas depois da última mensagem do cliente, só é permitido enviar modelo aprovado, segundo a documentação de preços da própria Meta. E todo modelo de marketing é cobrado.

    Por que a integração não oficial arrisca o número?

    A não oficial esbarra nos Termos de Serviço do WhatsApp, que listam como uso não permitido “mensagens em massa, mensagens automáticas” e acesso por “meios não autorizados ou automatizados”. A falta de custo por mensagem é o que atrai. Mas não existe plataforma oficial protegendo o número se ele cair.

    Quantas mensagens por dia a API oficial deixa mandar?

    A Meta conta por destinatários únicos em 24 horas, fora da janela de atendimento. Segundo a documentação de limites de mensagens, uma conta nova começa em 250 por dia. Sobe para 2.000 com verificação do negócio ou depois de 2.000 envios entregues em 30 dias com modelos de alta qualidade.

    Daí em diante as faixas são 10.000, 100.000 e ilimitado, liberadas automaticamente quando a qualidade está alta e o negócio usou pelo menos metade do limite nos últimos 7 dias. A qualidade é o portão de todas as faixas: denúncia e bloqueio travam a subida.

    Na prática, quanto tempo leva uma base de 1.890 contatos pela API oficial?

    Com a nossa base limpa de 1.890 contatos válidos, a conta pela regra da Meta fica assim:

    Situação da contaLimite em 24hTempo para cobrir a base
    Empresa verificada2.0001 dia
    Conta nova, sem verificação250cerca de 8 dias

    O limite conta pessoas diferentes contatadas pela empresa fora da janela de atendimento, num período móvel de 24 horas. Responder quem mandou mensagem não entra nessa conta. Ou seja: o volume raramente é o gargalo. O que decide é a qualidade do modelo, e é por isso que mandar tudo no primeiro dia, só porque o limite permite, continua sendo má ideia.

    Como preparamos uma base de 2.482 contatos antigos antes de enviar

    O caso é nosso: uma base de 2.482 contatos antigos de um produto digital de entrada, preparada para reativação por WhatsApp com automação própria. Antes da primeira mensagem, a base passou por uma limpeza. Ela mudou o tamanho real da campanha:

    EtapaContatos
    Base original2.482
    Descartados por telefone inválido592
    Com telefone válido1.890
    Com nome real no cadastro425
    Sem nome (mensagem sem saudação pelo nome)1.465

    Os 592 descartados eram números zerados, fixos sem o 9 e DDD inexistente. Mandar para número que não existe só gera erro e desperdiça envio, então saíram antes do primeiro disparo.

    Que ritmo, lote e intervalo usamos?

    O ritmo foi decidido para não atropelar uma base que esfriou, bem abaixo de qualquer limite de plataforma:

    • 20 mensagens por dia, divididas em 4 lotes de 5
    • Um a dois minutos entre uma mensagem e outra, para dar tempo de conferir o que saiu e parar a fila se algo der errado
    • Janela das 9h às 18h, de terça a sexta
    • Freio automático: a fila para sozinha depois de 3 erros seguidos

    A fila e o freio foram montados como script (um pequeno programa que executa os passos sozinho) com o Claude Code. Eles rodam dentro do nosso CRM (o sistema onde ficam os contatos e o histórico de cada cliente).

    A conta tem um custo claro: 1.890 contatos a 20 por dia são cerca de 95 dias de envio, ou uns seis meses na janela de quatro dias por semana. Lento é o preço de não perder o número.

    Com a API oficial, ainda precisa de freio?

    Precisa, mas o freio muda de função. Na oficial, o teto de volume é da Meta, pela faixa da conta. Ninguém precisa inventar um teto próprio. O que continua perigoso é a reação de quem recebe.

    Segundo a documentação de qualidade de modelos, um modelo com feedback negativo de vários usuários ou baixa taxa de leitura pode mudar de status, e fora do status aprovado ele não pode mais ser enviado. Para base fria, o freio vira isto: mandar em ondas, olhar a qualidade do modelo antes da próxima e parar a fila depois de erros seguidos.

    Por que não usamos o disparo em massa que o sistema já tinha?

    O CRM tinha uma função de envio em massa pronta, e ela foi proibida de rodar nessa campanha: o intervalo entre mensagens era de 100 milissegundos, sem teto diário.

    Com esse intervalo, os 2.500 contatos sairiam em uns 4 minutos. Para uma base que não fala com a empresa há meses, é a receita de denúncia em massa, e denúncia é o que derruba a qualidade do número. Ter um botão de disparo não significa que ele esteja calibrado para a sua base.

    O que quebrou nos primeiros lotes?

    Os dois primeiros lotes, de 5 mensagens cada, expuseram dois problemas que nenhum teste com o próprio número mostraria:

    1. Número válido sem WhatsApp travava a fila. O telefone passava na validação, mas não tinha conta no aplicativo, e a fila tentava de novo sem parar.
    2. Nome errado na saudação. Um contato tinha cadastrado como “nome” um DDD entre parênteses. Ele recebeu a saudação com esses números no lugar do nome.

    Nasceu daí uma checagem tripla antes de cada lote: conferir telefone, conferir se o nome é mesmo um nome e conferir o texto final que vai sair. O lote seguinte saiu com zero erro.

    Como evitar mandar duas vezes para a mesma pessoa?

    O estado da campanha não fica na memória de ninguém nem numa planilha paralela. Cada envio bem-sucedido aplica uma etiqueta no contato dentro do CRM. A fila é recalculada a cada disparo, a partir de quem ainda não tem essa etiqueta.

    Isso resolve dois problemas de uma vez. É impossível alguém receber a mesma mensagem duas vezes. E, se a conexão cair no meio de um lote, a fila retoma de onde parou sem ninguém recontar à mão.

    E se o cadastro antigo estiver sujo?

    Quase sempre está. Na nossa base, 1.918 registros tinham o e-mail gravado no campo do nome, defeito de uma importação antiga. A tentação é extrair o nome do e-mail, e ela erra feio: um endereço como “sobrinhoaparecida85” vira “Sobrinhoaparecida”.

    A saída foi separar a base em duas fases. Primeiro, quem tem nome real, com saudação personalizada. Depois, o restante, com uma variante da mensagem que não usa nome. Saudação errada soa como spam, e spam gera denúncia.

    O que colocar na mensagem para reduzir denúncia?

    A política dá a direção, e a prática confirma:

    • Lembrar de onde a pessoa conhece você logo na primeira linha. Contato antigo não lembra do cadastro
    • Oferecer uma saída explícita, como “se não quiser mais receber, é só responder SAIR”, e cumprir na hora
    • Tirar da fila quem pediu para sair, pelo mesmo mecanismo de etiqueta, para que nenhum lote futuro volte a falar com essa pessoa
    • Uma mensagem só, sem sequência automática para quem não respondeu

    Para quem respondeu e esfriou, o caminho é outro, detalhado em como fazer follow-up de orçamento que o cliente não respondeu.

    Qual caminho escolher?

    A recomendação é uma só: API oficial. É o caminho que a política protege. Você paga por modelo de marketing e respeita o limite da faixa, mas troca o risco de perder o número por uma regra clara e publicada. O custo mensal dessa conta está em quanto custa o agente de IA do WhatsApp Business.

    A integração não oficial fica fora dos termos de serviço, e nenhum ritmo baixo muda isso: não é caminho para o número de que o negócio depende. E vale saber de antemão o que dá errado quando um agente de IA atende no WhatsApp.

    Quando reativar a base se aplica bem — e quando não?

    Se aplica bem a quem tem uma base que deu o número e aceitou contato. É a condição da política do WhatsApp citada no começo. Com ela, a reativação é contato com gente que já te conhece.

    Também serve a quem aceita ir devagar. Na nossa base, o ritmo de 20 por dia levaria cerca de 95 dias de envio. Quem precisa de resposta em uma semana vai se frustrar.

    Não se aplica a lista comprada, nem a número que nunca pediu contato. Falta o opt-in, e a política não abre exceção. Também não se aplica a quem já pediu para sair: esse contato sai da fila e não volta.

    Como resolver isso com IA, passo a passo?

    1. O que construir. Um agente de reativação ligado só à API oficial do WhatsApp. Ele faz em ordem tudo o que este artigo descreve: limpa a base, separa quem tem nome real, envia o modelo aprovado em ondas pequenas, confere a qualidade do modelo antes de cada onda e para a fila sozinho depois de 3 erros seguidos. Cada envio vira uma etiqueta no CRM, e quem responde SAIR sai da fila para sempre. Dá para montar com o Claude Code, a ferramenta da Anthropic que escreve e roda o código a partir de um pedido em português.

    2. O pedido pronto para copiar. O pedido que recomendamos colar no Claude Code:

    “Monte um agente de reativação de clientes antigos que use só a API oficial do WhatsApp (WhatsApp Business Platform, da Meta), com modelo de mensagem já aprovado. Antes de enviar: 1) descarte telefones inválidos, como número zerado, fixo sem o 9 e DDD que não existe; 2) separe quem tem nome real de quem tem e-mail ou números no campo do nome, e nunca tire nome de dentro de e-mail; 3) me mostre quantos contatos sobraram em cada grupo e espere meu ok. Ao enviar: mande em ondas pequenas, no horário comercial; antes de cada onda, confira se o modelo continua aprovado e com qualidade boa; pare a fila depois de 3 erros seguidos; marque cada contato enviado com uma etiqueta no CRM para nunca mandar duas vezes; e tire da fila na hora quem responder SAIR. Explique cada passo como se eu nunca tivesse programado.”

    Como conferir se o agente acertou antes do primeiro envio?

    3. O teste da base de 2.482. Rode só a limpeza, sem enviar nada, e compare com a tabela deste artigo. Na nossa base, a conta certa era: 2.482 na origem, 592 descartados, 1.890 válidos, 425 com nome real e 1.465 sem nome. Na sua base os números serão outros, mas a conta tem que fechar do mesmo jeito: descartados mais válidos igual ao total. Depois, plante dois cadastros-armadilha: um com um DDD entre parênteses no lugar do nome e outro com “sobrinhoaparecida85” no nome. Os dois têm que cair no grupo sem nome. Se algum receber saudação, o agente está reprovado.

    Quanto custa e quanto tempo leva para rodar?

    4. Custo e tempo. Há dois custos. O primeiro é a Meta: todo modelo de marketing é cobrado, e a conta mensal está em quanto custa o agente de IA do WhatsApp Business. O segundo é a ferramenta para montar o agente: a página oficial de preços do Claude, vista do Brasil em 02/10/2026, mostra o plano Pro a R$ 110 no mensal ou R$ 92 por mês no anual (R$ 1.100 de uma vez), com o Claude Code incluído. O plano Free não inclui o Claude Code, e os preços não incluem impostos aplicáveis.

    O tempo de envio sai das contas deste artigo: 1.890 contatos levam 1 dia numa empresa verificada, cerca de 8 dias numa conta nova, ou cerca de 95 dias de envio no ritmo de 20 por dia. O tempo para montar o agente depende do seu CRM; não medimos esse número à parte.

    O que a gente faria no seu lugar?

    A gente limparia a base antes de qualquer envio. No nosso caso, 592 dos 2.482 contatos tinham telefone inválido. Mandar para eles só queimaria a qualidade do número.

    A gente começaria pelos 425 contatos com nome real, pela API oficial. E olharia a qualidade do modelo antes de cada nova onda, como pede a documentação da Meta. Deixaríamos essa rotina inteira com o agente de reativação do passo a passo acima, com a limpeza conferida por uma pessoa antes do primeiro envio.

    O que a gente não faria: apertar o botão de disparo em massa só porque ele existe. Nem tirar o nome do cliente de dentro do e-mail. As duas coisas geram mensagem com cara de spam, e spam gera denúncia.

    Em resumo

    Reativar clientes antigos pelo WhatsApp sem bloqueio pede a API oficial e três regras: só falar com quem deu o número e aceitou contato, mandar em ondas pequenas olhando a qualidade do modelo, e tirar da fila na hora quem pedir para sair. Na nossa base de 2.482 contatos, isso significou limpar 592 números inválidos antes de começar e travar o ritmo em 20 mensagens por dia, com freio automático após 3 erros seguidos.

    Este artigo faz parte do pilar Atendimento que não escala — como automatizar sem virar robô chato.

  • Dá pra mexer em campanha do Google Ads sem abrir o painel — e o que nunca deveria mudar sem alguém aprovar?

    Dá pra mexer em campanha do Google Ads sem abrir o painel — e o que nunca deveria mudar sem alguém aprovar?

    Dá. O Google Ads tem uma API (a porta que o Google abre para outro sistema conversar com a conta). Ela deixa ler métricas, puxar termos de pesquisa e alterar campanhas por código. Exige projeto no Google Cloud com a API ativada, login autorizado e nível de acesso para contas reais. Orçamento, lance e pausa só mudam com aprovação humana.

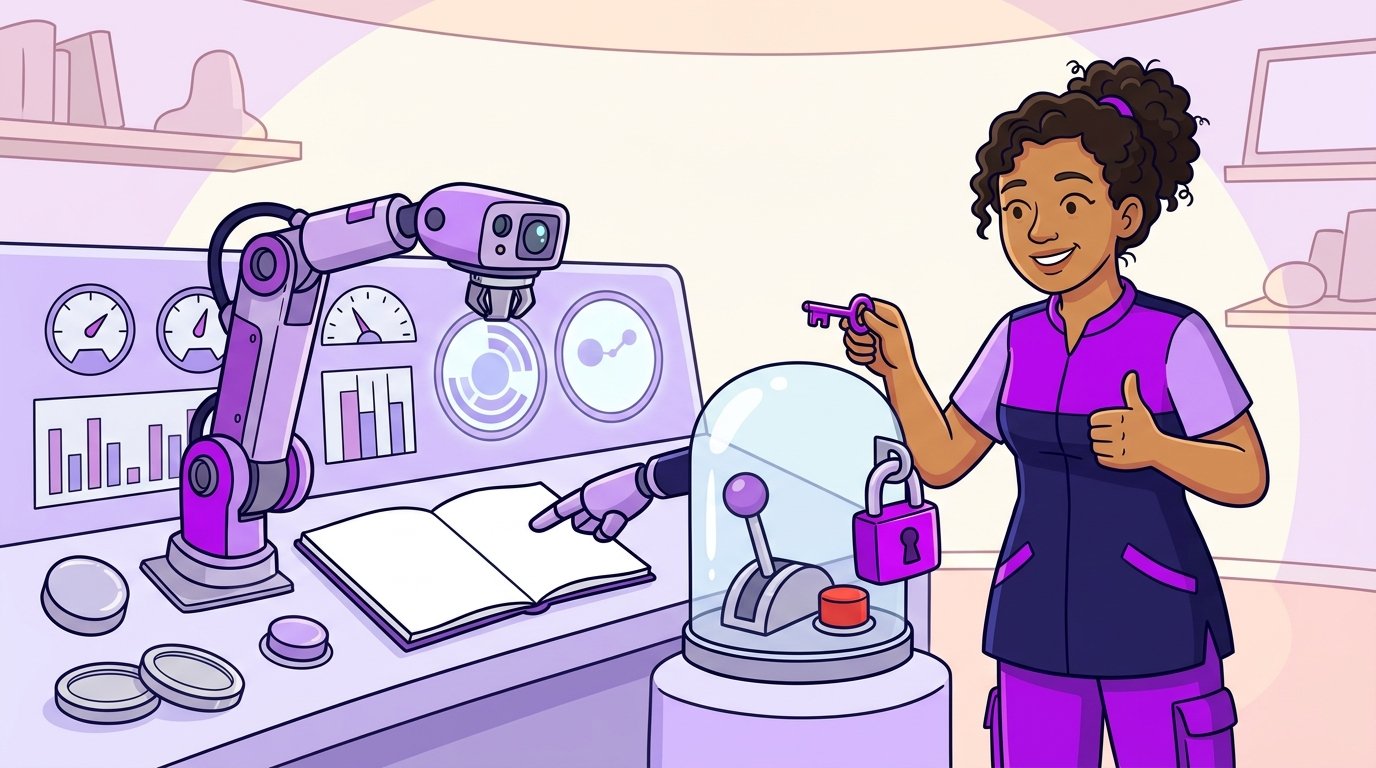
    Braço robótico lendo painéis de uma sala de controle, enquanto os botões de dinheiro ficam numa redoma trancada com a chave na mão da dona.
    A automação lê tudo sozinha. Mexer em orçamento, lance ou pausa fica trancado até alguém aprovar.

    Você anuncia no Google e passa o começo do dia abrindo aba por aba. Quer ver quanto gastou, que palavra puxou clique ruim e se a campanha ainda está no ar. Esse trabalho é o tipo que um script (um pequeno programa que faz a mesma tarefa sozinho) faz melhor. O que ele não deve fazer é decidir sozinho onde vai o seu dinheiro.

    O que um sistema próprio consegue fazer com a API do Google Ads?

    Na prática, três famílias de tarefa saem do painel e vão para o código:

    TarefaExemploRisco
    Lergasto do dia, cliques, conversões, custo por conversãonenhum, só consulta
    Limpartermos de pesquisa que geraram clique inútil, virando palavra negativabaixo
    Mexer em valor ou statusorçamento, lance, meta de custo por aquisição, pausaralto: é dinheiro correndo

    Ler é onde está quase todo o ganho de tempo. Um relatório que junta gasto, termos e conversões num lugar só substitui a volta diária pelo painel. Como montar esse tipo de visão consolidada está em como juntar dado de várias fontes num painel só.

    O que a API exige antes da primeira chamada?

    A regra mudou em 2026, e muito tutorial ainda descreve o modelo antigo. O token, ou seja, a espécie de senha técnica que identificava quem chamava a API, deixou de existir. Pela documentação oficial do token de desenvolvedor, esses tokens foram descontinuados em 9 de setembro de 2026.

    O acesso passou a ser vinculado ao projeto do Google Cloud. E a conta de administrador, chamada MCC (a conta que gerencia várias contas de anúncio de uma vez), deixou de ser obrigatória para se inscrever.

    O que sobra para configurar:

    • um projeto no Google Cloud com a Google Ads API ativada;
    • credenciais OAuth desse projeto, ou seja, o login em que você autoriza o sistema a agir na sua conta Google. Depois do login, elas viram um token de atualização (a chave que renova o acesso sem pedir login de novo);
    • um nível de acesso que permita contas de produção;
    • o identificador da conta de administrador em cada chamada, se o seu acesso à conta de anúncios passa por uma MCC.

    O último item também está na documentação da API: quem acessa via conta de administrador e não informa esse cabeçalho recebe erro de permissão.

    Quais são os níveis de acesso e qual basta para um negócio?

    A página oficial de níveis de acesso lista quatro, todos gerenciados no projeto do Google Cloud:

    NívelContas reais?Limite diário em produçãoComo se consegue
    Testenão, só contas de teste—vem ao ativar a API
    Exploraçãosim2.880 operaçõespedido no próprio console
    Básicosim15.000 operaçõesexige verificação da marca
    Padrãosimsem limiteanálise de cerca de 10 dias úteis

    Para quem administra as próprias campanhas, Exploração costuma bastar: libera conta real e o limite diário sobra para leitura e ajustes pontuais. Os níveis acima fazem sentido para ferramenta que atende muitas contas.

    Como foi ligar isso numa conta real?

    Montamos a conexão no fim de agosto de 2026 e ela só funcionou de ponta a ponta em 17 de setembro, contra uma conta real. No caminho houve três tropeços que nenhum passo a passo mencionava.

    O que deu errado no caminho até a conta real?

    O primeiro: um e-mail de aprovação de acesso básico chegou em 1º de setembro, e mesmo assim a chamada de teste falhava dizendo que o projeto não estava aprovado para produção. O motivo era a migração: o projeto do Google Cloud tinha nascido de novo no nível Teste, no sistema novo. Pedimos Exploração pelo console e a aprovação saiu em menos de um minuto.

    O segundo: montar a requisição à mão, direto no endereço da API, devolveu erro 404 (o código de “endereço não encontrado”) na nossa tentativa. Com a biblioteca oficial em Python (uma linguagem de programação), a mesma consulta trouxe as campanhas reais da conta.

    O terceiro: o servidor local, ou seja, o programa no próprio computador que recebe a resposta do login, caiu depois do redirecionamento. O código de autorização continuava na barra de endereço por alguns minutos. Deu para trocá-lo por token sem refazer o consentimento.

    O código foi escrito e depurado com o Claude Code, e as credenciais ficam num arquivo fora do repositório e fora do controle de versão.

    Quem aprova cada mudança, e o que impede um erro caro?

    Uma divisão escrita antes do primeiro comando de escrita, e não depois do primeiro susto. A nossa ficou assim:

    • Pode fazer sem perguntar, e mostrar depois o que mudou: metas e ações de conversão, palavras negativas, correções técnicas de configuração.
    • Sempre para e pede aprovação, mostrando valor atual e valor novo: meta de custo por aquisição, orçamento, lance ou teto de custo por clique, ajustes de lance por local ou dispositivo, pausar campanha.
    • Nunca faz: ativar campanha ou anúncio. Toda campanha criada por código sai pausada, e quem liga é uma pessoa.

    Em campanha ativa, a regra aperta: um “pode seguir” dado para um valor não vale para o próximo. Cada número novo passa por um OK novo. Como dar autonomia a um agente sem transformar isso em aprovação de cada passo está em como fazer o agente rodar sozinho sem aprovar cada passo.

    Por que confirmar valor se a própria conta pode mudar sozinha?

    Porque o número que o script leu ontem pode não ser o de hoje. O Google Ads tem a opção de aplicar recomendações automaticamente, e entre elas estão ajustar metas de custo por aquisição, trocar a estratégia de lance e adicionar palavras-chave. Além disso, outra pessoa com acesso à conta pode ter mexido.

    Por isso a aprovação mostra o valor atual lido na hora, lado a lado com o novo. Se o valor atual já não bate com o que você esperava, isso é um alerta, não um detalhe: algo mudou na conta sem passar por você.

    Qual armadilha o status de pausa esconde?

    A pausa não mora num lugar só. Quando uma campanha é importada com tudo pausado, ela fica pausada em quatro níveis: campanha, grupo de anúncios, palavra-chave e anúncio. Ativar só a campanha faz o painel mostrá-la como ativada, e mesmo assim ela entrega zero impressão.

    Descobrimos isso em agosto de 2026, conferindo campanhas recém-importadas. O diagnóstico natural seria culpar palavra sem volume ou lance baixo. O erro estaria três níveis abaixo.

    Duas consequências para quem automatiza. O script precisa ler os quatro níveis antes de concluir qualquer coisa sobre veiculação. E ligar continua sendo decisão humana, nível por nível.

    Quando vale automatizar o Google Ads — e quando não?

    Se aplica bem:

    • Quem abre o painel todo dia para as mesmas conferências. Gasto, termos e conversões num relatório só substituem essa volta.
    • Quem limpa termos de pesquisa com frequência. Transformar clique inútil em palavra negativa é tarefa repetida e de risco baixo.
    • Quem cuida de várias campanhas ou contas. Aí a leitura por código economiza mais, e a MCC organiza o acesso.

    Não se aplica tão bem:

    • Uma campanha pequena, olhada uma vez por semana. Projeto no Google Cloud, login autorizado e nível de acesso dão mais trabalho que a própria volta pelo painel.
    • Quando não há ninguém para aprovar mudança no dia. A trava depende de uma pessoa dizer sim ou não. Sem ela, a automação só serve para ler.
    • Quando ninguém vai cuidar das credenciais. O acesso precisa ficar guardado fora do código, e alguém tem que saber onde.

    Como resolver isso com IA, passo a passo?

    1. O que construir

    Um relatório diário de leitura, montado pelo Claude Code (a ferramenta da Anthropic que escreve e roda o código a partir de um pedido em português). Ele usa a biblioteca oficial da Google Ads API e entrega, num arquivo só, o gasto do dia, os cliques, as conversões, os termos de pesquisa e o status de cada campanha nos quatro níveis de pausa. Não muda nada na conta: só lê. Mexer em valor fica para depois, e sempre com aprovação.

    2. O pedido pronto para copiar

    O pedido que recomendamos colar no Claude Code, depois de ter o projeto no Google Cloud com a API ativada e o nível Exploração aprovado:

    “Monte um script em Python usando só a biblioteca oficial da Google Ads API, sem montar requisição à mão. Ele deve apenas LER a minha conta, nunca alterar nada. Quero um relatório diário com: gasto do dia, cliques, conversões e custo por conversão de cada campanha; os termos de pesquisa que geraram clique sem conversão; e o status de cada campanha nos quatro níveis — campanha, grupo de anúncios, palavra-chave e anúncio. Guarde as credenciais num arquivo separado, fora do código e fora do controle de versão. Se o meu acesso passa por uma conta de administrador, inclua o identificador dela em cada chamada. Explique cada passo como se eu nunca tivesse programado.”

    3. Como conferir se a IA acertou

    Use a armadilha da pausa descrita acima como teste. Escolha uma campanha que o painel mostra como ativada, mas que tenha um grupo de anúncios ou uma palavra-chave pausada. O relatório certo aponta exatamente em qual dos quatro níveis está a pausa. Se ele disser só “ativada”, reprovou. Confira também um número: o gasto do dia no relatório precisa bater com o do painel.

    4. Custo e tempo

    O Claude Code vem no plano Pro do Claude, que custa R$ 110 no mensal ou R$ 92 por mês no anual (R$ 1.100 de uma vez), conforme a página oficial de preços vista do Brasil em 02/10/2026; os preços não incluem impostos aplicáveis. O plano grátis não inclui o Claude Code. O nível Exploração dá 2.880 operações por dia, que sobram para um relatório diário. Quanto ao tempo, depende da conta: no nosso caso, a conexão levou do fim de agosto até 17 de setembro de 2026 por causa dos três tropeços acima, e o pedido do nível Exploração saiu em menos de um minuto.

    O que a gente faria no seu lugar?

    A gente começaria só lendo, com o relatório diário montado pelo Claude Code no passo a passo acima. Na tabela das três famílias de tarefa, ler é risco zero e é onde está quase todo o ganho de tempo. Um relatório diário já tira você da volta pelo painel.

    Para acesso, a gente pediria o nível Exploração. Ele libera conta real, saiu em menos de um minuto no nosso caso, e 2.880 operações por dia sobram para quem administra as próprias campanhas.

    O que a gente não faria: deixar o código mudar orçamento, lance ou pausa sem mostrar o valor atual e o novo. Não ativaria campanha por código. E não montaria requisição à mão quando existe biblioteca oficial, porque foi aí que tomamos o erro 404.

    Em resumo

    A API do Google Ads permite ler métricas, limpar termos de pesquisa e ajustar campanhas por código, desde que o projeto do Google Cloud tenha a API ativada, login OAuth e pelo menos o nível Exploração para contas reais.

    O que separa automação útil de prejuízo é a trava: orçamento, lance, meta de custo e pausa só mudam com aprovação humana mostrando valor atual e novo, e nenhuma campanha é ativada por código.

    Quando a automação quebra mesmo com a tela dizendo que está tudo certo, o caminho está em quem conserta a automação que a IA construiu.

    Este artigo faz parte do pilar Operação e processo — como documentar sem virar burocracia.
  • O que fazer quando a automação que a IA construiu quebra e a tela dizia que estava tudo certo?

    O que fazer quando a automação que a IA construiu quebra e a tela dizia que estava tudo certo?

    Quem conserta é quem construiu, mas só se existir prova de que quebrou de verdade — não a tela dizendo que deu certo. Numa campanha de anúncios que administro, a tela mostrava “orçamento salvo”, mas ao recarregar a página o valor voltava a R$0,00. O conserto foi recarregar, comparar com o que ficou gravado, e refazer até bater.

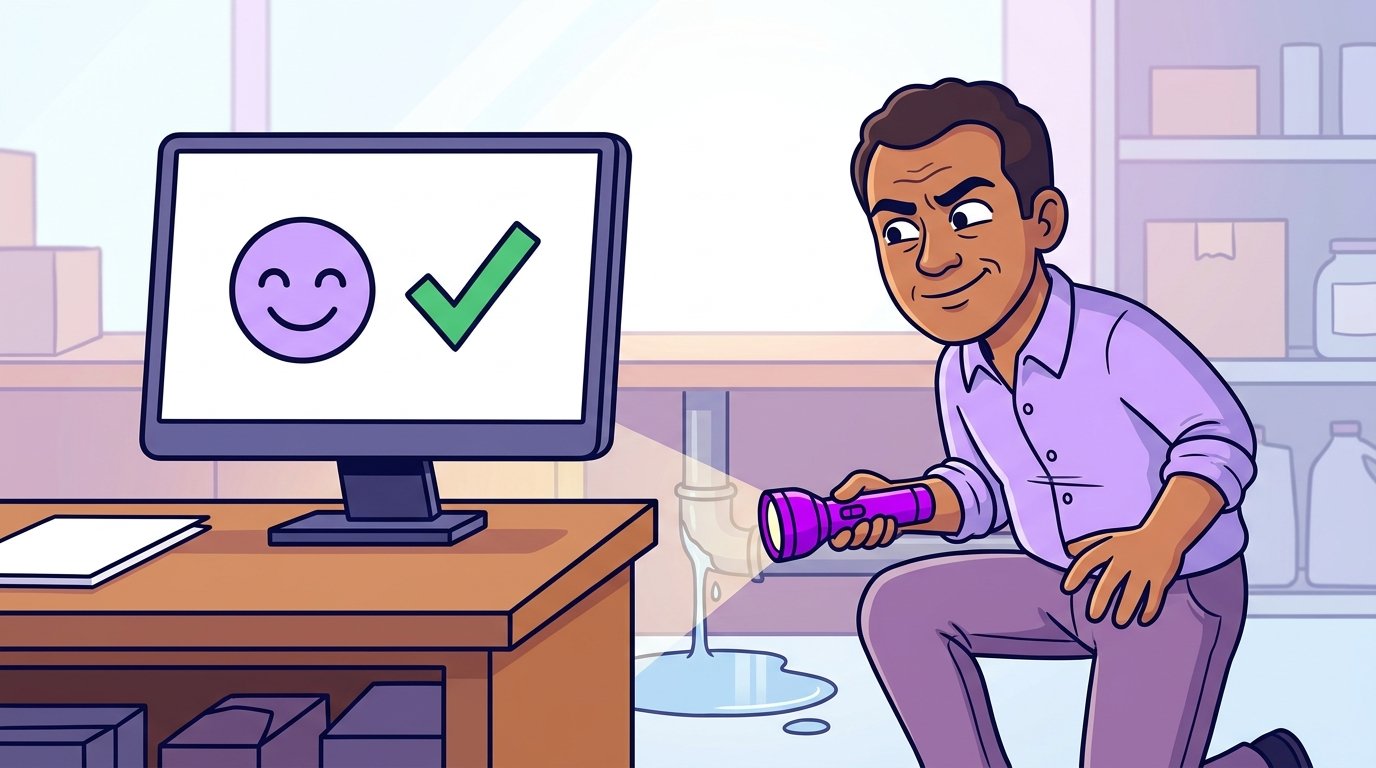
    Tela de computador exibindo um check verde enquanto um cano vaza escondido atrás, e o dono ilumina o vazamento com uma lanterna roxa.
    A tela dizia que estava tudo certo. A prova de que funcionou vem de conferir o resultado de verdade.

    Isso muda a resposta para “quem conserta”. Não basta pedir para a IA arrumar de novo. Primeiro é preciso provar onde a informação parou de bater: na tela, no servidor (o computador onde o sistema guarda os dados de verdade) ou nos dois.

    Por que uma tela pode mostrar “sucesso” e não ter salvo nada?

    Porque a confirmação na tela e o dado gravado no servidor são duas coisas separadas. Uma pode falhar sem a outra perceber. A tela só avisa que o pedido saiu. Ela não garante que o pedido chegou e foi aceito.

    No caso da campanha de anúncios, um aviso de verificação de identidade da conta tinha aparecido pouco antes. A suspeita é que aquilo travou a escrita em silêncio numa etapa específica do processo. As outras etapas continuavam respondendo normal.

    O sintoma: o campo de orçamento diário voltava a zero a cada recarregamento. Isso mesmo depois de digitar o valor várias vezes e a tela confirmar “salvo”. Palavras-chave e anúncio também não existiam de verdade no servidor, apesar de o assistente mostrar tudo pronto.

    Onde falha a automação que responde “ok”?

    Nos pontos em que o sistema responde “ok” para uma coisa e faz outra. O orçamento zerado não foi um caso isolado. No mesmo trabalho com anúncios e com um CRM (o sistema que guarda a lista de contatos e clientes), apareceram outras falhas da mesma família:

    Onde falhouO que a tela diziaO que era de verdade
    Limite de preço por cliqueCampanha prontaCampo vazio: a campanha podia pagar quanto quisesse por clique
    Extras do anúncio importados por planilhaImportação concluídaOs extras nunca subiram
    Título de anúncio importadoTexto aceitoUma palavra perdeu letras por erro de acentuação e virou outra palavra válida
    Formulário do CRM“Enviado com sucesso”O contato com telefone repetido foi juntado ao antigo, sem criar um novo

    Por que esses erros enganam até quem confere?

    O limite de clique vazio custou R$19,45 num único dia: 3 cliques, a R$6,48 cada, em média. Foi o erro mais barato de descobrir e o mais caro de ignorar.

    O caso do título é o mais traiçoeiro. Não sobrou nenhum símbolo estranho para dar alarme. Só comparando campo a campo com o texto original dava para ver.

    O do formulário engana até quem testa. Quem reenvia com o mesmo telefone de teste acha que o contato “não chegou”. Ele chegou, só foi juntado ao que já existia.

    Como descobrir que algo quebrou antes que vire prejuízo?

    Recarregando a página depois de qualquer ação de salvar, sempre. A mensagem de sucesso sozinha nunca vale como prova.

    Foi assim que, numa checagem de rotina, apareceram duas campanhas ativas gastando com a lista de palavras bloqueadas completamente vazia. O plano de bloqueio existia no registro interno. Mas nunca tinha sido aplicado de fato na campanha real. As duas foram pausadas assim que o problema apareceu.

    Na prática, a conferência tem quatro passos:

    1. Salvar e recarregar a página, sem confiar no aviso de “salvo”.
    2. Comparar o valor na tela com o valor que você pediu, número por número.
    3. Testar com um dado novo, nunca com um que o sistema já conhece.
    4. Anotar a diferença antes de pedir o conserto, para a IA atacar a causa e não o sintoma.
    Sinal de alertaO que ele revelou
    Campo de orçamento voltava a R$0,00 sozinhoEscrita bloqueada silenciosamente numa etapa específica
    Lista de bloqueio vazia numa campanha ativaConfiguração planejada nunca aplicada de verdade
    Aviso de “verificação de identidade” pendenteProvável causa raiz das duas falhas acima

    Quem é responsável quando a IA constrói e algo quebra depois?

    Quem construiu investiga a causa. No meu caso, sempre com o Claude Code lendo o erro e propondo o conserto. Mas quem aprova religar o que estava quebrado é sempre uma pessoa, nunca a própria automação sozinha.

    No caso das campanhas pausadas, a reativação ficou esperando aprovação humana mesmo depois da correção aplicada. O motivo: aquele erro específico ainda não tinha explicação 100% confirmada.

    Essa divisão virou regra escrita. Ajuste técnico de configuração, como preencher uma lista de palavras bloqueadas, pode ser feito e mostrado depois. Já qualquer valor em dinheiro — orçamento, lance, custo por venda — só muda com o “ok” da pessoa, vendo o número atual e o novo lado a lado.

    Pausar campanha também pede esse “ok”. Ligar anúncio, nunca: esse clique é sempre humano. E com campanha no ar, um “pode seguir” dado antes não vale para um valor novo.

    Quando essa regra se aplica bem — e quando não?

    Ela se aplica bem nos seguintes casos:

    • Automação que mexe com dinheiro, como anúncio, cobrança ou orçamento.
    • Sistema que grava dado de cliente, como CRM ou formulário de cadastro.
    • Importação em lote por planilha, em que um erro se repete em muitas linhas de uma vez.
    • Qualquer tela em que a plataforma mostrou um aviso pouco antes, como um pedido de verificação de conta.

    Ela vale menos esforço quando o resultado aparece na sua frente na hora e não custa nada errar. Um rascunho, um teste que ninguém vai usar para decidir, um botão que mudou de cor. Nesses casos, recarregar e comparar custa mais tempo do que o erro custaria.

    O que muda depois desse tipo de erro?

    Vira regra permanente: toda ação de “salvar” passa a ser conferida recarregando a tela, nunca pela mensagem de sucesso isolada.

    É o mesmo princípio por trás de tratar dado sensível com cuidado redobrado, descrito em é seguro usar IA com dado de cliente no meu negócio. Confiar sem checar é o erro que se repete em qualquer sistema automatizado, não só em anúncio.

    Como resolver isso com IA, passo a passo?

    1. O que construir. Uma skill de conferência no Claude Code (uma skill é um conjunto de instruções salvas que a IA segue sempre do mesmo jeito). Depois de cada ação de salvar, ela lê de novo o que ficou gravado e monta uma tabela com três colunas: o que foi pedido, o que ficou gravado e se os dois batem. Ela aponta a diferença, mas não religa nada e não muda valor em dinheiro sem o “ok” de uma pessoa.

    2. O pedido pronto para copiar. O pedido que recomendamos colar no Claude Code:

    “Crie uma skill chamada ‘conferir depois de salvar’. Toda vez que você salvar algo num sistema meu, faça isto: 1) leia de novo o valor gravado, sem confiar na mensagem de sucesso; 2) me mostre uma tabela com o que eu pedi, o que ficou gravado e se bate, campo por campo, letra por letra nos textos; 3) se algum campo estiver vazio ou diferente, pare e me diga onde divergiu antes de tentar consertar; 4) teste cadastros sempre com um dado novo, nunca com um que o sistema já conhece; 5) qualquer valor em dinheiro, como orçamento ou lance, só muda com meu ‘ok’, mostrando o valor atual e o novo lado a lado; 6) nunca religue nada sozinha. Explique em português simples.”

    Como conferir se a skill pega o erro de verdade?

    3. O teste do orçamento zerado. Use os casos da tabela deste artigo. Salve um orçamento e confira: se o valor gravado voltar a R$0,00, a skill tem que marcar “não bate”, mesmo com a tela dizendo “salvo”. Deixe o limite de preço por clique vazio de propósito: ela tem que acusar o campo vazio. Mande o formulário com um telefone que já existe: ela tem que avisar que o contato foi juntado ao antigo. Se qualquer um passar como “ok”, a skill está reprovada.

    Quanto custa e quanto tempo leva para montar a skill?

    4. Custo e tempo. A skill roda no Claude Code. A página oficial de preços do Claude, vista do Brasil em 02/10/2026, mostra o plano Pro a R$ 110 no mensal ou R$ 92 por mês no anual (R$ 1.100 de uma vez), com o Claude Code incluído. O plano Free é R$ 0 e não inclui o Claude Code. Os preços não incluem impostos aplicáveis. O tempo não medimos à parte; depende de quantos sistemas ela vai conferir. Como régua de custo do erro, o limite de clique vazio custou R$19,45 num único dia.

    O que a gente faria no seu lugar?

    Nós trataríamos toda mensagem de “salvo com sucesso” como um palpite, não como prova. O motivo está no próprio caso: o orçamento voltou a R$0,00 várias vezes com a tela dizendo “salvo”. E o limite de clique vazio custou R$19,45 em um dia só.

    Faríamos a conferência logo depois de cada ação que mexe com dinheiro ou com dado de cliente. Não no fim do mês, quando o estrago já somou. E não faríamos isso de memória: deixaríamos a skill “conferir depois de salvar” rodar sozinha a cada ação, devolvendo a tabela de pedido contra gravado.

    O que não faríamos: pedir para a IA “arrumar de novo” sem antes mostrar onde a tela e o dado gravado divergem. Também não deixaríamos a própria automação religar o que estava quebrado. Religar é decisão de uma pessoa.

    Em resumo

    Quando uma automação construída com IA quebra depois de pronta, quem conserta é quem construiu. Mas o primeiro passo nunca é confiar na mensagem de sucesso da tela.

    É comparar o que a tela mostra com o que realmente está gravado, achar onde os dois divergem, e só então religar, com aprovação humana explícita.

    Este artigo faz parte do pilar Eu não sou programador — dá pra construir com IA mesmo assim?.

  • Como automatizar mensagens no Instagram — e por que a automação trava mesmo com o código pronto?

    Como automatizar mensagens no Instagram — e por que a automação trava mesmo com o código pronto?

    Uma automação pode estar 100% pronta no código e ainda não funcionar, porque a trava não é técnica, é de permissão da plataforma. Construí um agente que lê comentário, responde publicamente e tenta enviar mensagem privada no Instagram. As duas primeiras funcionam; a terceira trava com o erro “Application does not have the capability”: falta a revisão formal da Meta.

    Carro roxo novinho parado numa cancela fechada, com um guarda apontando para um carimbo de autorização que falta.
    O código pode estar pronto e mesmo assim não passar: a liberação depende da autorização da plataforma.

    Isso não é exclusivo do Instagram. É um padrão comum: uma parte da automação pede acesso a algo sensível (mensagem privada, dado financeiro, publicação em nome de outro). A plataforma exige que um humano da empresa dona da API (a porta que um sistema abre para outro conversar com ele) aprove esse acesso antes de liberar, mesmo com o código certo.

    O que funcionou de verdade nessa automação?

    Duas das três etapas funcionaram sem barreira nenhuma. Ler os comentários de um post (`GET /{media-id}/comments`) funcionou de primeira.

    Responder um comentário publicamente (`POST /{comment-id}/replies`) também funcionou. Foi testado ao vivo em comentários reais, e a resposta apareceu publicada normalmente.

    O código foi escrito com o Claude Code — a ferramenta da Anthropic que escreve e roda programas a partir de pedidos em português. A parte técnica não foi o gargalo.

    Onde exatamente ela travou?

    A terceira etapa era enviar uma mensagem privada em resposta ao comentário. O recurso se chama “Private Reply”, via `POST /{ig-id}/messages`. Ele retornou o erro de código 3: “Application does not have the capability”.

    O token — a chave digital que prova que o app pode agir pela conta — já tinha as permissões `instagram_manage_messages` e `instagram_manage_comments`. Elas estavam concedidas em nível básico. Isso não bastou.

    Por que a Meta bloqueia isso mesmo com o código certo?

    Porque enviar mensagem privada em nome de uma conta empresarial é uma permissão de acesso avançado. E acesso avançado exige passar pelo App Review da Meta.

    O App Review é a revisão em que a equipe da plataforma analisa o uso pedido. Geralmente pede a descrição do caso de uso e uma gravação de tela mostrando a função funcionando. Segundo a própria Meta, ela testa o app de verdade: se não conseguir acessá-lo para testar, a submissão inteira é recusada.

    Uma tentativa de contorno que não funciona: inscrever a página no campo de eventos de mensagem (`subscribed_apps`) direto, sem passar pela revisão. Isso retorna outro erro (código 200). Esse caminho pertence ao Messenger do Facebook, não ao Instagram. São sistemas de permissão diferentes por baixo.

    Qual é o problema que quase ninguém conta?

    A trava não para na mensagem privada. Ela chega antes, no aviso de comentário novo.

    Para responder sozinha, a automação precisa ser avisada de que alguém comentou. Esse aviso automático se chama webhook (um “toca a campainha” que a plataforma manda para o seu sistema quando algo acontece).

    A documentação de webhooks do Instagram diz, com todas as letras: “Advanced Access is required to receive comments and live_comments webhook notifications”. Ou seja: sem acesso avançado, o aviso de comentário não chega.

    No nosso caso, o sistema estava todo ligado. O teste manual do painel da Meta chegou ao sistema. Mas nenhum comentário real disparou aviso. Cadastrar uma segunda conta como “testadora” do app também não resolveu: o comentário dela não gerou aviso nenhum.

    A mesma página traz mais duas exigências. O app precisa estar no modo Live (publicado, e não em desenvolvimento). E a empresa por trás do app precisa ter passado pela verificação de negócio da Meta.

    Como resolver isso com IA, passo a passo?

    1. O que construir

    Um agente de comentários feito com o Claude Code e ligado só à API oficial da Meta para o Instagram. Ele faz as três etapas deste artigo: lê os comentários, responde em público e, depois da revisão da Meta, manda a mensagem privada (“Private Reply”). Ferramenta que imita o aplicativo para escapar da revisão fica de fora: o caminho é o oficial.

    A IA escreve o programa; a liberação, quem dá é a Meta. Pelo que as páginas oficiais exigem, a ordem é esta:

    1. Verificar a empresa. A Meta exige verificação de negócio para qualquer app que peça acesso avançado. Confira se o app está no portfólio da empresa verificada. No nosso caso, o app estava num portfólio sem verificação, e esse foi o primeiro passo a corrigir.
    2. Pedir só o que usa. A Meta avisa que pedir permissão desnecessária é um motivo comum de recusa. Para comentário e mensagem, são as duas permissões citadas acima.
    3. Gravar o vídeo. Mostre o fluxo completo: alguém comenta, a automação responde, a mensagem sai.
    4. Deixar o app acessível para teste. Sem isso, a revisão reprova tudo de uma vez.
    5. Colocar o app em Live depois da aprovação, para os avisos começarem a chegar.

    2. O pedido pronto para copiar

    O pedido que recomendamos colar no Claude Code:

    Monte um agente de comentários para o Instagram da minha empresa usando só a API oficial da Meta.
    1) Receba o aviso de comentário novo (webhook) e, enquanto ele não chegar, busque os comentários de tempos em tempos.
    2) Responda em público com o texto que eu definir, apontando para o link do perfil.
    3) Deixe pronta, mas desligada, a mensagem privada (Private Reply), para ligar só depois que o App Review aprovar.
    4) Peça só as permissões instagram_manage_comments e instagram_manage_messages.
    5) Grave um registro de cada comentário e de cada resposta, para eu usar no vídeo da revisão.
    6) Me mostre o que preciso fazer no painel da Meta, como se eu nunca tivesse programado.

    3. Como conferir se a IA acertou

    Use as provas deste artigo. Ler comentários e responder em público têm que funcionar já no nível básico: a resposta precisa aparecer publicada no post. Se a mensagem privada devolver o erro de código 3, “Application does not have the capability”, o código não está errado. Falta o acesso avançado. E se o teste do painel chegar ao sistema, mas comentário real não, é o mesmo sinal: a trava é de permissão, não de programa.

    4. Custo e tempo

    O Claude Code entra a partir do plano Pro do Claude: R$ 110 no mensal ou R$ 92 por mês no anual (R$ 1.100 de uma vez), segundo a página oficial de preços vista do Brasil em 02/10/2026; os preços não incluem impostos aplicáveis. O plano gratuito não inclui o Claude Code. O tempo do código não foi o gargalo neste caso. O prazo que manda é o da revisão da Meta, e as páginas citadas não trazem esse número: conte que depende dela.

    Quando a revisão ainda não saiu, o que dá para fazer?

    A saída foi separar o que já funciona do que depende de terceiro. Publicar a resposta automática no comentário, que já estava liberada, sem prometer, no texto dessa resposta, que uma mensagem privada viria em seguida.

    Prometer algo que ainda depende de aprovação externa é o tipo de promessa que o próprio processo pode não cumprir no prazo que a pessoa espera. No lugar, a resposta pública aponta para o link do perfil.

    Em paralelo, a revisão formal da permissão pode ser solicitada. Ela não bloqueia o resto da automação enquanto está em análise, só a etapa específica de mensagem privada.

    Um agente de resposta automática que já lê e responde comentário sozinho está descrito em como transformar uma tabela de preço em orçamento automático e em como montar um atendente que agenda horário sozinho.

    Para quem isso se aplica — e para quem não?

    Se aplica bem para quem:

    • está montando o próprio sistema de “comentou, recebeu mensagem” usando a API da Meta direto;
    • já tem o código funcionando nos testes, mas nada acontece com comentário de gente de verdade;
    • quer usar a mesma lógica em outra ação sensível, como publicar em nome de outra conta.

    Não se aplica para quem:

    • usa uma ferramenta pronta que já passou pela revisão da Meta. Nesse caso, a ferramenta já tem o acesso avançado, e você só conecta a sua conta;
    • só quer ler comentários e responder em público, com a automação indo buscar os comentários de tempos em tempos (em vez de esperar o aviso). Isso funcionou em nível básico no nosso teste;
    • não tem empresa verificada nem pretende verificar. Sem isso, o acesso avançado não sai.

    O que a gente faria no seu lugar?

    A gente começaria pela papelada, não pelo código. Antes de escrever uma linha, conferiria se a empresa está verificada e se o app está no portfólio certo.

    O motivo é o nosso próprio caso: o código ficou pronto e provado, e mesmo assim nenhum aviso de comentário chegou. A trava estava na permissão, não no programa.

    Enquanto a revisão não sai, a gente colocaria no ar só a resposta pública, sem prometer mensagem privada. O que funciona hoje entrega valor hoje. O agente com IA descrito acima já nasce assim: resposta pública ligada e mensagem privada pronta para ligar quando a Meta aprovar.

    O que a gente não faria: gastar dias tentando contornar a revisão. Inscrever a página por outro caminho e cadastrar conta testadora foram testados aqui, e nenhum dos dois funcionou.

    Em resumo

    Código pronto não é o mesmo que automação liberada: quando a ação envolve dado sensível de terceiro — como mensagem privada em nome de uma empresa —, a plataforma dona da API exige revisão humana antes, independente de o código estar certo. A saída não é insistir tentando contornar: é separar o que já funciona hoje do que depende de aprovação externa, e não prometer o que ainda não foi liberado.

    Este artigo faz parte do pilar Casos reais — quanto custou, quanto tempo levou e o que quebrou.

  • Quanto custa construir um CRM sem contratar dev — e por que isso quase apagou os dados de produção?

    Quanto custa construir um CRM sem contratar dev — e por que isso quase apagou os dados de produção?

    Dá para montar um CRM (sistema que organiza contatos e vendas) completo sem contratar desenvolvedor, partindo de código-fonte pronto e ajustando com IA — o gasto real vira infraestrutura, não mão de obra. Hoje isso custa R$43,99 por mês de aluguel do computador onde ele roda, dividido com outros dois sistemas. O resto do custo foi tempo, não dinheiro.

    Homem reformando uma casinha com uma ferramenta roxa e segurando a tempo uma caixa de fotos antigas que quase foi pro lixo.
    Construir saiu barato. O risco de verdade estava no que já existia no ar e não tinha cópia em lugar nenhum.

    Não teve orçamento de agência nem fatura de freelancer. O sistema roda em produção há semanas, atendendo leads de verdade. Lead é a pessoa que deixou o contato e pode virar cliente. E o que ele custou de fato só ficou claro depois de rodar por um tempo, não no dia em que “ficou pronto”.

    O que significa construir sem contratar desenvolvedor?

    Significa partir de um código-fonte que já existe e ajustar, corrigir e estender esse código com IA. Nesse caso, a base foi um template (um modelo pronto) de CRM já usado por outra operação. A ferramenta foi o Claude Code, uma IA que escreve e roda o código. Não se abriu vaga nem se contratou por job.

    O ponto não é “a IA escreveu tudo do zero sozinha”. É que não existiu curva de aprendizado de linguagem nem reunião de escopo com terceiro. O pedido virava código no mesmo dia, testado na hora.

    Quanto custa de infraestrutura, de verdade?

    O único custo recorrente e mensurável é o servidor (o computador ligado 24 horas onde o sistema fica no ar). No caso, um VPS (servidor virtual privado: um pedaço de um computador grande, alugado só para você) de nível básico.

    O plano KVM 2 na Hostinger custa hoje R$43,99 por mês na tabela oficial, com preço promocional aplicado. Esse valor não é exclusivo do CRM. No mesmo servidor rodam mais dois processos além dele, dividindo o custo sem dividir a fatura.

    ItemCusto
    Servidor (VPS, plano básico)R$43,99/mês (tabela atual)
    Mão de obra de desenvolvedorR$0 — nenhuma contratação
    Licença de banco de dadosR$0 — SQLite (banco de dados que cabe num arquivo só), sem custo de licença
    Tempo de configuração inicial1 sessão de trabalho, num único dia

    O que quebrou no meio do caminho?

    Duas coisas quebraram de verdade, e nenhuma delas era o código do CRM em si.

    A primeira foi uma peça pronta de que o sistema depende. A biblioteca que lê e grava o banco de dados local (better-sqlite3) não tinha versão pré-compilada (já montada, pronta para usar) para a versão mais nova do Node.js (o motor que faz o sistema funcionar). Então tentou se montar na hora. Isso exige um compilador C++ que não estava instalado.

    O conserto foi trocar para a versão mais recente da mesma biblioteca. Ela já vem pré-compilada e não depende de compilador nenhum. Fica o aviso: se um dia o Node.js for trocado de versão, o mesmo tropeço pode voltar.

    A segunda foi mais séria. O código baixado para editar localmente não era um repositório Git de verdade (o histórico organizado de todas as versões do código). Era só um arquivo compactado.

    E o servidor de produção tinha etiquetas de cliente, como “cliente ativo” ou “cancelado”, que não existiam em nenhuma cópia fora dele. Subir o código local por cima do servidor, sem checar isso antes, teria apagado essas etiquetas sem deixar rastro.

    Por que não dá para confiar em produção sem repositório de código organizado?

    Porque ninguém sabe ao certo o que existe só lá. Essa foi a lição que ficou. Antes de qualquer envio de código para um servidor em produção, o primeiro passo virou olhar o que já existe lá. Histórico de versão, configuração, dado que não está em lugar nenhum fora daquele servidor. E nunca sobrescrever sem comparar.

    Um exemplo menor do mesmo tipo de problema: seis de sete formulários de captura de lead estavam configurados sem etiqueta de entrada. Isso só apareceu quando alguém contou manualmente — apenas dois de sete leads estavam etiquetados na tela. Não era bug de código, era configuração vazia que ninguém tinha ido conferir.

    Como subir uma mudança sem apagar o que já está no ar?

    O roteiro de atualização que ficou documentado tem uma ordem fixa. Nenhum passo pula o anterior:

    1. Olhar antes de tocar. No servidor, conferir o histórico e o que mudou lá desde a última versão. Alguém pode ter ajustado algo à mão.
    2. Fazer cópia de segurança do banco de dados. Se der errado, há para onde voltar.
    3. Trazer a versão nova do código, só depois de comparar com o que está lá.
    4. Aplicar os ajustes na estrutura do banco, quando a versão nova pedir.
    5. Reiniciar o sistema e conferir que ele voltou.

    Uma regra vale em todos os passos: o arquivo com as senhas do sistema nunca sobe junto. O servidor tem o dele. Cada instalação, inclusive a do computador de quem edita, tem suas próprias chaves e seu próprio banco.

    Vale mais montar do zero ou partir de um template pronto?

    Partir de um código já existente encurtou o tempo de semanas para um único dia de configuração inicial. Mas trouxe justamente esse tipo de risco: peça escondida de que o sistema depende, dado de produção que a cópia local não tem e comportamento que só o servidor real conhece.

    Como esse caminho se compara a montar do zero ou comprar um sistema pronto está detalhado em comprar um sistema pronto ou construir o meu com IA.

    Quando vale esse caminho — e para quem ele não serve?

    Ele se aplica bem nos seguintes casos:

    • Negócio que já tem um CRM de código aberto ou um template para partir, em vez de começar do zero.
    • Quem aceita pagar em tempo o que deixaria de pagar em mensalidade ou em desenvolvedor.
    • Quem pode dividir um servidor com outros sistemas, como aconteceu aqui com mais dois processos.

    Ele não serve bem para quem precisa de alguém de plantão quando o sistema cai. Aqui, a manutenção é de quem construiu. Também não serve para quem vai mexer em produção sem cópia de segurança e sem olhar o histórico antes. Foi exatamente esse atalho que quase apagou as etiquetas dos clientes.

    Como resolver isso com IA, passo a passo?

    1. O que construir. Uma skill no Claude (um conjunto de instruções salvas que a IA segue sempre do mesmo jeito) chamada “atualizar CRM com segurança”. Ela transforma o roteiro de cinco passos deste artigo em regra fixa. Antes de qualquer envio, ela lista o que existe só no servidor, faz a cópia do banco e só então sobe a versão nova. Quem roda é o Claude Code, a mesma ferramenta usada para ajustar o CRM.

    2. O pedido pronto para copiar. O pedido que recomendamos colar no Claude Code:

    “Crie uma skill chamada ‘atualizar CRM com segurança’. Toda vez que eu pedir para subir uma mudança no servidor, siga esta ordem e não pule nenhum passo: 1) entre no servidor e me mostre o que mudou lá desde a última versão, incluindo etiquetas, formulários e configurações que não existem na minha cópia local; 2) faça uma cópia de segurança do banco de dados e me diga onde ela ficou; 3) compare o código novo com o que está no servidor e me mostre as diferenças antes de enviar; 4) aplique os ajustes na estrutura do banco só se a versão nova pedir; 5) reinicie o sistema e confira que ele voltou. Nunca envie o arquivo de senhas. Se encontrar algo que só existe no servidor, pare e me pergunte. Explique cada passo como se eu nunca tivesse programado.”

    Como conferir se a skill acertou antes de mexer no servidor real?

    3. O teste das etiquetas. Use os dois tropeços deste artigo como prova. Primeiro: numa cópia de teste do servidor, crie uma etiqueta de cliente que não existe na cópia local, do mesmo jeito que “cliente ativo” só existia lá. A skill certa para no passo 1 e mostra essa etiqueta antes de enviar qualquer coisa. Segundo: peça para ela contar os formulários de captura sem etiqueta de entrada. No caso deste artigo, a resposta certa era seis de sete. Se ela subir o código sem avisar da etiqueta, está reprovada.

    Quanto custa e quanto tempo leva para montar essa skill?

    4. Custo e tempo. O servidor continua sendo o custo do artigo: R$43,99 por mês no plano KVM 2 da Hostinger, dividido com outros dois sistemas.

    Para usar o Claude Code, a página oficial de preços do Claude, vista do Brasil em 02/10/2026, mostra o plano Pro a R$ 110 no mensal ou R$ 92 por mês no anual (R$ 1.100 de uma vez). O plano Free é R$ 0, mas não inclui o Claude Code. A página avisa que os preços não incluem impostos aplicáveis.

    O tempo de referência é o do próprio caso: a configuração inicial do CRM coube em uma sessão de trabalho, num único dia. O tempo para escrever e testar a skill depende do seu sistema; não medimos esse número à parte.

    O que a gente faria no seu lugar?

    Nós partiríamos de um template pronto, e não do zero. O motivo é o próprio número do caso: a configuração inicial coube em um dia, e o custo fixo ficou em R$43,99 por mês, dividido com outros dois sistemas.

    Mas trataríamos o servidor de produção como a única fonte de verdade desde o primeiro dia. Antes de qualquer envio, olharíamos o histórico e faríamos cópia do banco. E deixaríamos essa ordem gravada na skill “atualizar CRM com segurança”, para a IA cumprir sozinha toda vez, sem depender da memória de ninguém.

    O que não faríamos: subir uma cópia local por cima da produção só porque “no meu computador funciona”. As etiquetas de cliente que só existiam no servidor mostram o preço desse atalho.

    Em resumo

    Construir um CRM sem contratar desenvolvedor custou, na prática, R$43,99 por mês de servidor compartilhado e uma sessão de configuração. Mas o risco real não estava no código novo. Estava no que já existia em produção e não tinha cópia em lugar nenhum.

    Quem for pelo mesmo caminho ganha tempo, mas precisa tratar o servidor de produção como fonte de verdade, nunca a cópia local. Mais sobre o custo de manter esse tipo de sistema rodando com IA está em quanto custa usar o Claude Code no Brasil, em real, por mês.

    Este artigo faz parte do pilar Casos reais — quanto custou, quanto tempo levou e o que quebrou.

  • Minha planilha de controle virou um monstro. Como transformar isso num sistema?

    Minha planilha de controle virou um monstro. Como transformar isso num sistema?

    Uma planilha vira sistema no momento em que algo além de uma pessoa digitando precisa ler ou escrever nela de forma confiável: outro programa, uma automação, um relatório automático. É aí que a interface feita para clique humano falha. A saída costuma ser gerar o arquivo pronto por código, ou trocar a planilha por um banco de dados de verdade.

    De um lado, homem soterrado por uma planilha gigante e fios embolados; do outro, o mesmo homem sorrindo diante de um painel organizado.
    A planilha vira sistema quando outras partes do negócio precisam ler e escrever nela sem ninguém digitando.

    Você reconhece o momento. A planilha que começou com dez linhas virou quinze abas, cada uma com uma fórmula que só uma pessoa entende. Toda atualização é feita à mão, com medo de mexer numa célula errada e derrubar um cálculo que ninguém mais sabe refazer.

    E o problema raramente é o tamanho. É que, em algum momento, alguém tentou ligar aquilo a outra coisa. Pode ser um script (um pequeno programa que faz uma tarefa sozinho), um relatório automático, um processo que devia ler ou escrever ali sem ninguém. E foi exatamente aí que travou.

    Quando uma planilha deixa de ser planilha e vira sistema?

    Não é o número de abas nem a quantidade de linhas. O teste é outro: alguém além da pessoa que digita precisa confiar naquele dado sem abrir o arquivo e olhar?

    Se a resposta é sim, a planilha já parou de ser planilha. Um script lê dali todo dia, um relatório puxa aquele número, uma automação decide algo com base numa célula. Ela virou peça de um sistema. Só que ainda com a interface e as regras de uma ferramenta pensada para uma pessoa clicar.

    Por que a automação por clique trava justamente quando a planilha mais precisa dela?

    Porque a interface de uma planilha na nuvem foi desenhada para dedo e mouse humano. Os alvos são pequenos, e os menus mudam de lugar conforme o zoom da janela.

    Automação de navegador que clica em coordenadas de tela depende de cada botão estar sempre no mesmo lugar. Isso já é um problema geral de automação de interface. Telas com escalas diferentes criam dois sistemas de coordenada, o físico e o lógico. Eles se desalinham conforme muda o DPI (quantos pontos a tela desenha por polegada) ou o zoom.

    A documentação da Microsoft sobre escala de tela detalha esse desalinhamento. Numa planilha densa, com menus pequenos empilhados, o efeito aparece rápido.

    Qual é a diferença entre editar a planilha ao vivo na nuvem e gerar o arquivo pronto?

    Editar ao vivo depende da interface responder exatamente como esperado a cada clique: menu abrir, campo focar, seletor aparecer. Qualquer coordenada errada cai num lugar que não é o pretendido.

    Gerar o arquivo pronto muda onde o risco mora. Em vez de simular clique numa tela, o código escreve direto na estrutura do arquivo — célula, fonte, cor, filtro. Nenhuma interface visual precisa responder.

    Bibliotecas como o openpyxl fazem exatamente essa parte. Ele lê e grava arquivos `.xlsx` (o formato do Excel) em puro Python, com a formatação inteira pelo código, sem abrir programa nenhum.

    AspectoEditar ao vivo por cliqueGerar o arquivo pronto por código
    Depende de zoom/resolução da telaSimNão
    Onde o erro apareceNo clique errado, na horaNo código, antes de rodar
    Quem confirma o resultadoPrecisa reabrir a tela e olharO arquivo já sai pronto e formatado
    Fonte da verdadeA planilha na nuvemO arquivo gerado

    Quando vale a pena trocar a planilha por um banco de dados de verdade?

    Banco de dados é um arquivo ou serviço feito para guardar registros e deixar vários programas lerem e gravarem com segurança. Gerar o arquivo pronto resolve o caso mais comum: uma pessoa cuida do controle, e o que falta é confiabilidade na formatação e na atualização.

    Não resolve quando várias pessoas ou vários processos precisam escrever ao mesmo tempo. Aí sim é hora de banco de dados de verdade, com controle de quem grava o quê e quando.

    O sinal de que chegou essa hora não é o tamanho do arquivo, é a concorrência. Duas fontes tentando atualizar a mesma linha no mesmo minuto é o tipo de problema que arquivo e planilha não resolvem bem. Banco de dados existe justamente para isso. Isso pesa ainda mais quando o objetivo é juntar dado de fontes diferentes, como detalhamos em como juntar dado de várias fontes automaticamente num painel só.

    Como resolver isso com IA, passo a passo?

    Não saber programar não impede gerar o arquivo pronto. Impede fazer isso sozinho na hora. Mas o script se escreve uma vez e passa a rodar sempre que for preciso.

    É assim que esse tipo de script normalmente nasce hoje. Alguém descreve o que a planilha precisa ter — colunas, formatação, filtro. Uma ferramenta de código, como o Claude Code, escreve o programa que gera aquilo. A diferença para contratar por fora é que o resultado é um arquivo de texto simples, que dá para reabrir e pedir para ajustar depois.

    Como esse caminho se compara a montar a mesma automação numa plataforma visual está detalhado em Claude Code ou n8n/Make: qual resolve a automação do meu negócio.

    1. O que construir

    Um gerador de planilha: um script em Python, escrito pelo Claude Code (a ferramenta da Anthropic que escreve e roda o código a partir de um pedido em português), que lê o seu dado e grava o arquivo `.xlsx` já pronto com a biblioteca `openpyxl`. Ele entrega o arquivo formatado, com filtro e painel congelado, sem clicar em tela nenhuma. É o mesmo desenho da solução que ficou no caso deste artigo.

    2. O pedido pronto para copiar

    O pedido que recomendamos colar no Claude Code:

    “Escreva um script em Python com a biblioteca openpyxl que gere a minha planilha de controle como arquivo .xlsx pronto, sem abrir programa nenhum e sem automação de clique. A planilha deve ter estas colunas: [liste aqui]. Quero: cabeçalho em negrito com cor de fundo, primeira linha congelada, filtro em todas as colunas e formatação condicional para [descreva a regra, ex.: linha em vermelho quando o status for ‘atrasado’]. O dado vem de [diga de onde]. Salve o arquivo numa pasta local e explique cada passo como se eu nunca tivesse programado.”

    3. Como conferir se a IA acertou

    Use a lista do caso real como teste. Abra o arquivo gerado e confira os cinco itens que o script precisa escrever sozinho: fonte, cor, painéis congelados, filtro e formatação condicional. Role a planilha para baixo: o cabeçalho tem que ficar parado. Mude uma linha para a condição da regra e gere de novo: a cor tem que mudar. Se algum dos cinco faltar, peça o ajuste antes de usar.

    4. Custo e tempo

    O Claude Code vem no plano Pro do Claude: R$ 110 no mensal ou R$ 92 por mês no anual (R$ 1.100 de uma vez), segundo a página oficial de preços vista do Brasil em 02/10/2026; os preços não incluem impostos aplicáveis. O plano grátis não inclui o Claude Code. A biblioteca `openpyxl` é de código aberto. Depois de pronto, o script do caso deste artigo gera o arquivo em segundos; o tempo de escrever o primeiro depende de quantas abas e regras a planilha tem.

    O que deu errado quando tentei automatizar minha própria planilha?

    Montei um controle de artigos em Google Sheets. Tentei automatizar a edição dele por automação de navegador: clicar em menus e digitar em células pela interface visual, do jeito que uma pessoa faria na tela.

    Falhou 4 vezes seguidas. Na última, quebrou o próprio navegador — a captura de tela estourou o tempo de resposta. O que falhou, especificamente:

    • clique no menu “Formatar” não abria;
    • clique na caixa de fonte não abria o seletor;
    • clique na “caixa de nome”, pra pular pra uma célula, caiu no botão errado e abriu um diálogo de “Importar arquivo”;
    • clique pra fechar esse diálogo caiu no campo de busca de dentro dele.

    O diagnóstico bateu com o que a automação de interface tem de frágil em geral. Alvos pequenos, empilhados, com coordenada de clique que muda de posição conforme o zoom da janela.

    Vale registrar o que não generaliza. No mesmo dia, automação de navegador funcionou bem em outras ferramentas — WordPress, Gerenciador de Tags do Google, Search Console, YouTube. O problema foi específico da interface do Google Sheets, não uma regra de que toda automação de navegador falha.

    Qual foi a solução que ficou disso?

    Parei de tentar editar a planilha por fora. Passei a gerar o arquivo `.xlsx` já pronto por código, com a biblioteca `openpyxl`: fonte, cor, painéis congelados, filtro e formatação condicional, tudo escrito pelo script.

    O arquivo cai numa pasta local, e eu mesmo arrasto pro Google Drive quando quero ver na nuvem. São dois cliques, sem passar pelo menu de importação que travava antes.

    A regra que ficou: a fonte da verdade passou a ser o arquivo gerado, nunca mais a planilha na nuvem. Editar ao vivo na nuvem por automação de navegador deixou de ser algo que prometo nesse tipo de controle.

    Hoje o controle de artigos não é mais editado por clique nenhum. Ele sai pronto — formatado, com filtro e painel congelado — de um script que roda em segundos. A planilha na nuvem virou só o espelho que abro pra consultar.

    Para quem serve gerar o arquivo por código — e em quais casos não se aplica?

    Se aplica bem nestes casos:

    • uma pessoa só cuida do controle, e o que dói é formatar e atualizar à mão;
    • o dado já existe em outro lugar e a planilha é só o jeito de mostrar;
    • você tentou automatizar por clique e travou, como no caso acima.

    Não se aplica quando:

    • várias pessoas precisam digitar na mesma planilha ao mesmo tempo. Aí o caminho é banco de dados;
    • a planilha é consultada poucas vezes e ninguém depende dela todo dia. O esforço não se paga;
    • a equipe precisa editar ao vivo, célula por célula, na nuvem. O arquivo gerado é um retrato, não um lugar de trabalho.

    O que a gente faria no seu lugar?

    A gente pararia de tentar operar a planilha por fora. O caso deste artigo mostra o custo disso: 4 falhas seguidas e um navegador travado, só para mudar fonte e filtro.

    A gente escolheria uma fonte da verdade — o arquivo gerado ou o banco — e trataria o resto como espelho. É a regra que sobreviveu ao caso.

    Para o caso mais comum, uma pessoa só no controle, a gente pediria ao Claude Code o gerador de planilha do passo a passo acima e conferiria os cinco itens de formatação no primeiro arquivo.

    O que a gente não faria: migrar direto para um banco de dados só porque a planilha ficou grande. O sinal certo é concorrência, não tamanho. Com uma pessoa só no controle, gerar o arquivo pronto resolve com menos peças.

    Em resumo

    Planilha vira sistema quando algo além de uma pessoa precisa ler ou escrever nela sozinho — e é nesse ponto que a interface visual, feita para clique humano, costuma falhar. A saída não é abandonar a planilha: é parar de tentar operá-la de fora para dentro e passar a gerar o arquivo pronto direto do dado.

    Este artigo faz parte do pilar Do Excel ao sistema próprio.